DeepSeek Harness 深度体验:把万物皆插件做到极致的 AI 编程 Agent
DeepSeek Harness 深度体验:把万物皆插件做到极致的 AI 编程 Agent上周给 computeforge.cn 做流量预估,我在浏览器里开了十几个标签页,边翻数据边截图,翻到半夜一点才攒了两页笔记,烦得不行,才想起来试几天前刚冒出来的 DeepSeek Harness。当时我就一个念头:让它自己去查,自己算,给我一份报告就收工。 结果这一试,它还真把这活接住了。 凌晨两分钟装完,第一眼没什么可吹的安装没什么可讲的:一条 npx 命令拉起来,大概三分钟,版本号 0.1.0-rc.6,典型还没打磨完的样子。装完我好奇扫了眼 node_modules,里面躺着两百多个 @deepseek-ai/dsh-* 开头的包,光名字就铺了一屏。 浏览器打开 localhost:3080,界面说不上好看,就是个开源工程后台的脸:左边一列面板菜单,中间聊天区,右边留白。我当时心里想,又一个套壳聊天框。然后我瞥见右下角有个入口标着 Trajectory,当时没当回事。 凌晨 5 点 33,我给它下了第一单活第一单活跟我自己有关:访问 computeforge.cn...

Grok Bot 深度评测:xAI 的 AI 智能体能不能真的替你干活
Grok Bot 深度评测:xAI 的 AI 智能体能不能真的替你干活先把话说清楚Grok Bot 是 xAI 在 2026 年 8 月 11 日发布的 AI Agent(Early Beta)。它跟普通 Grok 聊天助手最大的区别是:每个 Bot 都有一台属于自己的云端电脑,能登录网站、操作浏览器、读文件、用工具,在后台自己干活,干完回来汇报,遇到要拿主意的节点再请你拍板。 所以它盯着的早就不是 ChatGPT、Claude 那条”聊天”赛道了,而是 AI Agent、Computer Use、自动化办公这一带。 先给你的判断,省得往下读半天: 你只是要聊天、写文章、总结资料——现在为它付几百美元一个月,不值。 你想把邮件、CRM、Bug 复现、内容生产这类多步骤的活整包丢给 AI——Grok Bot 值得盯着看,但到今天为止它还是”预售评估”,不是实测背书。 本文按它是什么、能干什么、跟同类怎么比、风险在哪、多少钱、适合谁这个顺序写。 Grok Bot 到底是什么一句话:xAI 推出的 AI Agent,特点不是”会聊天”,是自己有一台电脑。 按官方文档的说法,...

微信、支付宝直接购买 Codex ChatGPT Plus / Claude Pro,WildAI评测
微信、支付宝直接购买 Codex ChatGPT Plus / Claude Pro,WildAI评测先说结论:值不值,一眼看清WildAI(bewild.ai,也叫 BeWild AI)不是 OpenAI 或 Anthropic 的官方渠道,而是一个替你在自己账号上开通订阅服务的第三方平台。它的逻辑很简单:你付钱、交一段会话凭证,它把 ChatGPT Plus 或 Claude Pro 开到你的账号上,微信支付宝直接付,全程不用海外信用卡。 没绕开你该有的判断——它解决的是「支付」这个真问题,这也是国内用户想用官方订阅时唯一绕不过去的坎。 什么时候值得买: 你没有海外信用卡,也不想折腾虚拟卡; 天天重度用 ChatGPT Plus 或 Claude Pro; 坚持用自己账号,要保住历史对话和自定义 GPT。 什么时候别买: 有海外卡、官方能直订——直接去官方,别多付一层服务费; 只是偶尔用用——免费版够用,别花钱; 对账号凭证外流完全无法接受——看下面的本地部署方案。 三条铁律,先记住: 第一次只买 1 个月,别预付三个月。 只用干净的长龄账号...
Apple Silicon 跑本地大模型:M1 到 M4 的完整指南
Apple Silicon 跑本地大模型:M1 到 M4 的完整指南Mac 没有 NVIDIA 显卡,但 Apple Silicon 的统一内存架构让它跑大模型有独特优势:模型直接用内存跑,不用抠显存,还能低功耗待机。这篇文章覆盖 M1 到 M4 全系,讲清怎么选 Mac、用什么工具、各档机型能跑多大模型。 一、Apple Silicon 跑大模型的底层逻辑为什么 Mac 能跑大模型?关键在于统一内存(Unified Memory)。传统 PC 有独立的显存和内存,两者之间传数据是性能瓶颈;Apple Silicon 的 CPU、GPU 共享同一块内存,模型可以直接放在内存里跑,GPU 直接读——省去了数据搬运。 这带来两个直接结果: 显存=内存:你买 64GB 的 MacBook Pro,跑模型就能用到 64GB「显存」,这比任何消费级显卡都大; 门槛低:8GB 内存的入门 Mac 也能跑 7B 模型,而 NVIDIA 8GB 显卡已经被 14B 卡脖子。 代价也明显:内存带宽远低于显卡。NVIDIA 4090 带宽约 1TB/s,M3 Max 只...
Qwen3 各档显卡实测:4B 到 32B 该配什么显卡
Qwen3 各档显卡实测:4B 到 32B 该配什么显卡Qwen3 是目前中文用户本地部署的首选模型家族,从 4B 到 32B(还有 MoE 的 30B-A3B)覆盖了 6GB 到 48GB 全部显存档位。这篇用多张显卡实测 Qwen3 各档模型的速度、显存与体验,直接给你一张「显卡 × 模型」对照表。 一、测试环境与方法 项目 配置 显卡 RTX 3060 12G / RTX 4060 8G / RTX 3090 24G / RTX 4090 24G 工具 Ollama / llama.cpp,统一用适配显卡的配置 驱动 统一 560.94 模型 Qwen3 4B、8B、14B、30B-A3B(MoE)、32B 量化 Q4_K_M(MoE 用 Q4) 上下文 8K(与日常使用一致) > 提示:测试全部采用「模型完整进显存」的条件——这是本地推理的舒适区,只有整模型装进显存,速度才是它该有的样子。显存不够被迫分层 offload 的情况单列讨论。 测试方法补充速度测试统一用固定长度的中文问答(约 500 token 输出),取稳定输出段的平均...
RAG 切分与重排调优:把知识库问答准确率从 60% 提到 90%
RAG 切分与重排调优:把知识库问答准确率从 60% 提到 90%上一篇文章讲了怎么搭一套本地 RAG(检索增强生成),这次聊聊进阶:为什么同样的模型、同样的知识库,你的答案准确率只有六成?问题几乎都出在「切分(Chunking)」和「重排(Rerank)」这两个环节。这篇文章用实测数据告诉你怎么调。 一、先建立度量:没有评测集就别谈调优调优的第一步不是改参数,而是先有标尺。没有标准答案的对比,你根本不知道改完是好是坏。 建评测集三步走: 从知识库里挑 20~30 个真实问题(覆盖不同文档、不同难度); 对每个问题标注「应该命中哪几段」(期望检索结果); 跑一遍当前系统,记录命中率。 之后每次改切分/重排参数,都跑同一份评测集,看命中率变化。这一步的价值怎么强调都不为过——RAG 调优最大的坑就是「凭感觉调参」。 评测集怎么建才有代表性随便挑几个问题不算评测集。有代表性的评测集要注意: 难度分层:三分之一是「直接抄原文就能答」的简单题,三分之一是需要跨段拼接的中等题,三分之一是「原文里没写、需要推理」的难题。只挑简单题,命中率虚高,掩盖了系统真实水平; ...
faster-whisper 本地语音转写:会议纪要、字幕批量处理实战
faster-whisper 本地语音转写:会议纪要、字幕批量处理实战把一小时录音转成文字,网上工具要付费还要上传音频;faster-whisper 本地转写不仅免费、不用上传,速度还快——一段 10 分钟录音在普通显卡上 1 分钟内出稿。这篇文章从安装到批量出字幕,附 CPU/GPU 实测速度与踩坑记录。 一、faster-whisper 是什么faster-whisper 是 OpenAI Whisper 的重新实现,核心优化点是用了 CTranslate2 推理引擎,同样是跑模型,速度比原版 Whisper 快 4 倍左右、内存占用更低。API 跟原版兼容,迁移成本几乎为零。 先简单理解 Whisper 家族:OpenAI 开源的 Whisper 是语音转文字(ASR)模型的标杆,多语言、抗噪能力强,但原版推理用 PyTorch,速度偏慢、内存占用高。faster-whisper 把同样模型搬到 CTranslate2(C++ 推理引擎,支持 int8 量化),获得了接近 4 倍的速度提升,同时内存占用大幅下降——同样的模型,CPU 上就能跑得不错,这是它能流行...
Wan 2.2 本地视频生成全流程:ComfyUI 从安装到出片
Wan 2.2 本地视频生成全流程:ComfyUI 从安装到出片开源视频生成在 2026 年的答案基本是 Wan 2.2:画质高、中文支持好、ComfyUI 一条龙。这篇文章完整走一遍「模型下载 → ComfyUI 配置 → 文生视频 → 视频延长」,并给出不同显存下的实际参数和显存峰值规划。 一、Wan 2.2 是什么,需要什么配置Wan 2.2(阿里通义实验室)是开源视频生成模型,支持文生视频、图生视频、视频延长。相比同期的 LTX-Video、CogVideo,它的画面稳定性更好、中文 prompt 支持优秀,是目前中文用户本地跑视频的首选。 从模型家族说起:Wan 系列最早是通义万相的多模态模型,2025 年开源了支持视频的 2.1,随后 2.2 在画质、运动控制和中文理解上做了明显升级。它最大的特点是「一支模型既能文生视频、又能图生视频」,切换场景只需换输入,不需要换模型。对本地玩家来说,这意味着下一种模型就能覆盖多种玩法,学习成本和磁盘占用都很友好。 和云端视频生成(Sora、Kling、可灵)相比,本地 Wan 的定位很清楚:想要可控、可批量、不上传素材的创作者。...
VS Code + Continue 接入本地大模型:完全离线的 AI 编程助手
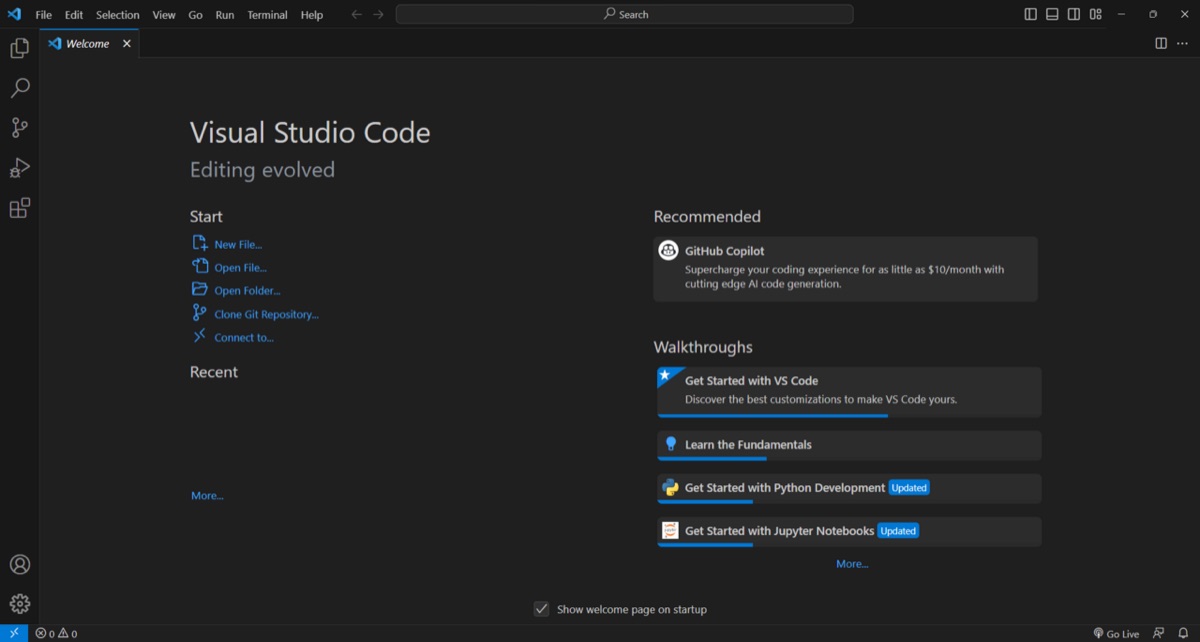
VS Code + Continue 接入本地大模型:完全离线的 AI 编程助手代码补全和对话是本地大模型最实用的两个场景,而 VS Code 里把两者整合得最好的免费插件就是 Continue。配上 Ollama 跑 Qwen3 Coder,你的代码助手全程离线、代码不上云。这篇文章从安装到配置调优,附实测速度。 一、Continue 是什么Continue 是 VS Code 的开源 AI 编程助手插件,对标 Copilot,但核心卖点是自由接模型:既能接 OpenAI 等云端 API,也能接本地 Ollama / llama.cpp 跑的模型。对在意代码隐私的开发者来说,本地模型 + Continue 是目前最成熟的自托管方案。 在深入之前,先搞清楚 Continue 与 Copilot 类工具的本质差异:Copilot 全家桶把模型、数据、功能都打包在一起,你只能用它内置的云端模型,代码片段会传到微软/OpenAI 的服务器;Continue 则把「模型层」完全开放——模型可以是本地的、可以是你自建的、也可以是任意云端 API。这种开放性让「代码不出...
DeepSeek R1 + AnythingLLM 搭建本地私有知识库:零 API、零上云
DeepSeek R1 + AnythingLLM 搭建本地私有知识库不想让公司文档、会议纪要出本地,又想要 AI 帮忙检索问答?AnythingLLM 是目前把「本地模型 + 本地向量库 + 可视化问答」整合得最省事的桌面工具,配合 DeepSeek R1 蒸馏版,全程零 API Key、零上云。这篇讲从安装到日常使用的完整流程。 一、为什么选 AnythingLLM + DeepSeek R1知识库问答的链路是「切分文档 → 向量化 → 检索 → 大模型生成」。AnythingLLM 把这个链路做成了桌面软件:你只管把文档丢进去,向量化、检索、调用模型它全包了,还能开 Web 端给团队用。 在搭建之前,先弄清楚「知识库问答」和「直接问模型」的本质区别:直接问模型,它只能凭训练时见过的数据回答,公司文档、个人笔记它根本不知道,而且答案无法溯源;知识库问答则先检索出「真实存在的段落」,再让模型基于这些段落作答——答案有出处、可核对,这是知识库方案的核心价值。AnythingLLM 把这条链路打包成了傻瓜式操作,降低了上手门槛,这也是它受欢迎的原因。 选 DeepSeek R1 ...