
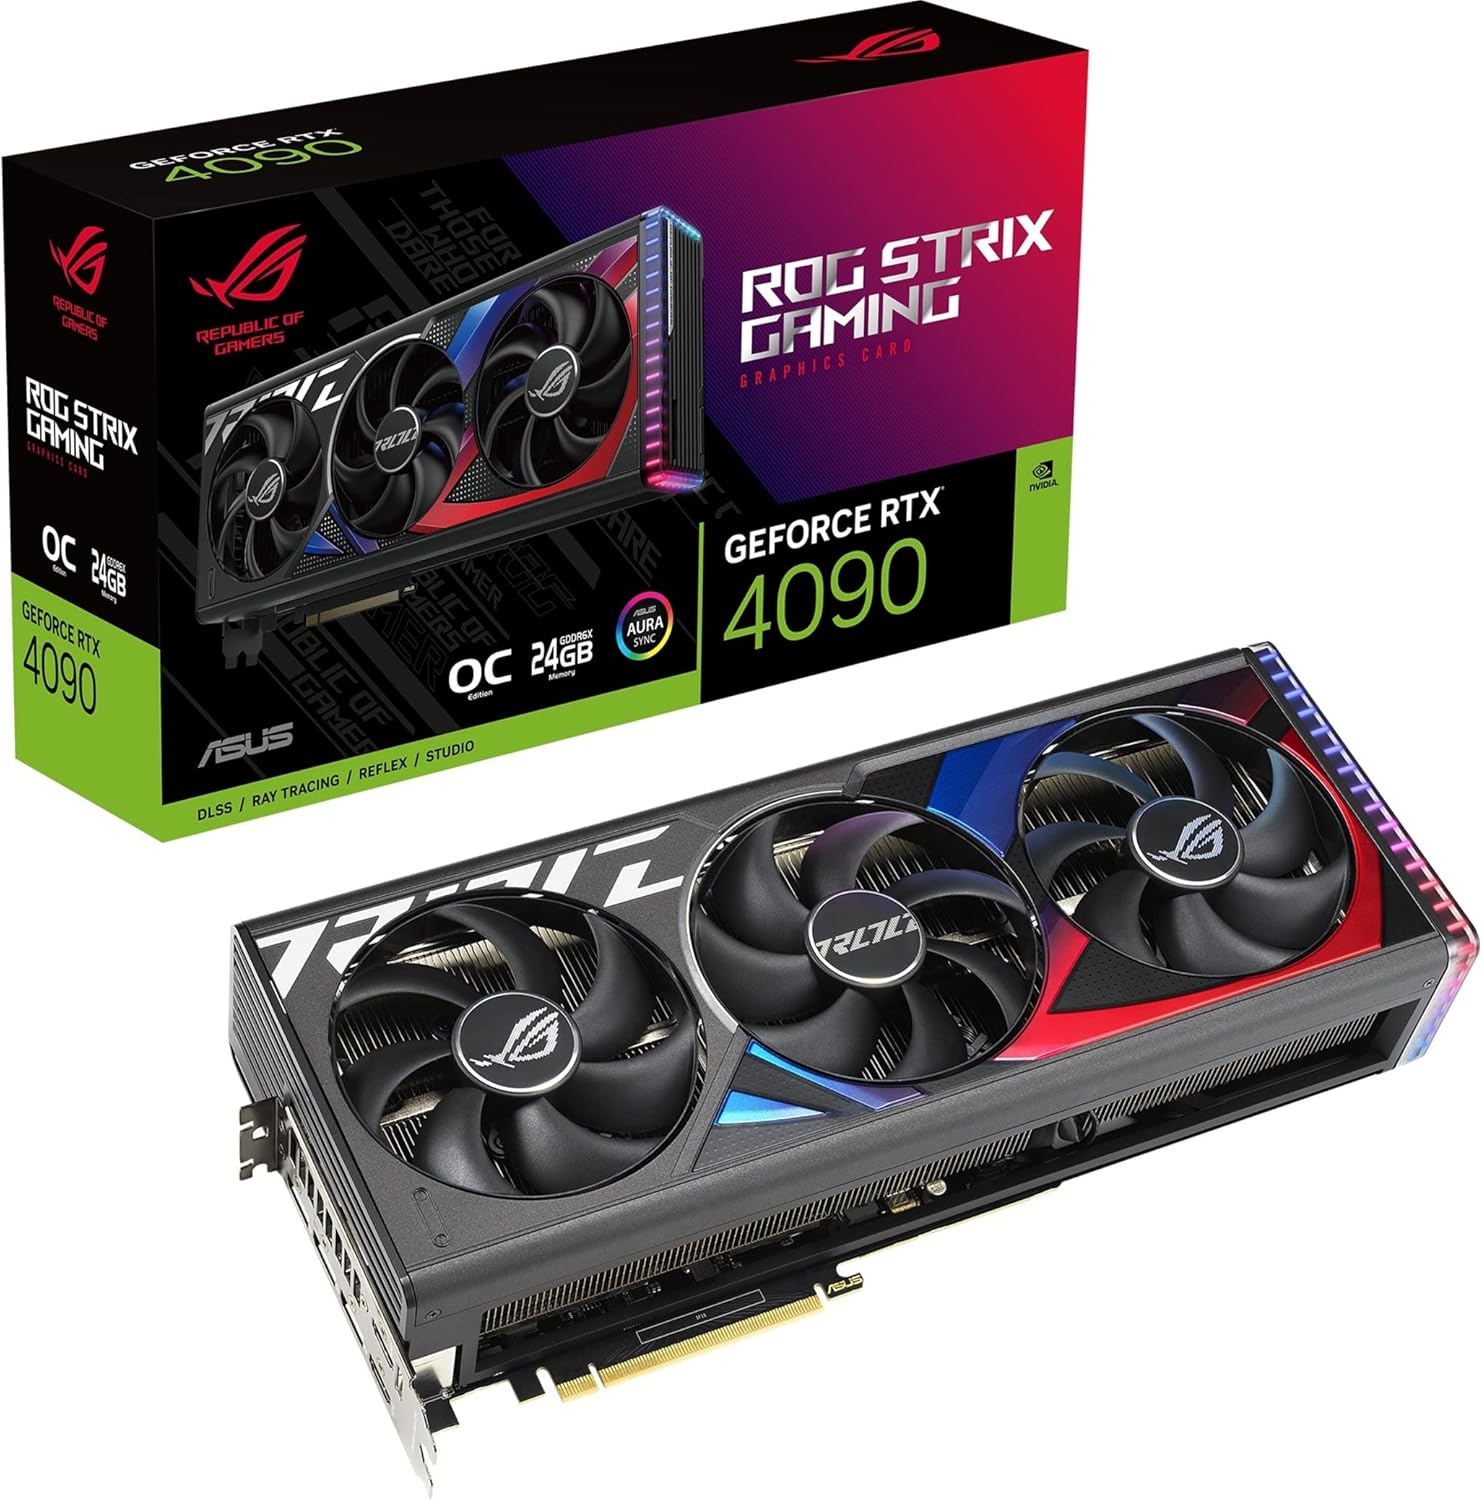
一句话介绍
RTX 4090 是 24GB 时代的「满血标杆」:同为 24GB 显存,却拥有顶尖的算力与生态,本地 AI 玩家的进阶默认卡。
深入了解
4090 是「24GB 显存 + 顶级性能」的完美样本,是本地 AI 从「能跑」走向「跑得好」的过渡卡,也是当前社区评测事实基准。
AI 能力评级
评级综合了本地大模型推理、图像/视频生成、性价比与静音表现,满分 10 分。
核心参数
- GPU 架构:Ada Lovelace (AD102)
- 显存容量:24GB GDDR6X
- 显存带宽:1008 GB/s
- FP16 算力:82.58 TFLOPS
- 功耗:450W
- 发布时间:2022年10月
为什么适合 AI
RTX 4090 代表 24GB 时代「算力与生态的双天花板」:TSMC 4N 工艺的 AD102 大核心带来 82 TFLOPS FP16,显存带宽 1008GB/s,二者共同把本地大模型体验推上新高度。gpubattle.com 首方实测中,Qwen3-32B Q4_K_M 达到约 44.28 token/s,Qwen2.5-Coder-14B Q4_K_M 约 95 token/s,Llama 3.1 8B 更可达 122~128 token/s——它在 24GB 显存范围内几乎榨干了带宽的上限。
对想低成本运行 70B 级模型的玩家,4090 是「单卡 24GB 的终极解」:Llama 3.1 70B Q4 量化约需 40GB,24GB 需配合部分 CPU 分流,但速度与稳定性已经明显优于 3090 的同方案。而 Qwen3 32B 这样 24GB 内能完整驻留的模型,4090 可接近「秒出」级别的流畅体验。
ComfyUI 侧 4090 同样挥洒:SDXL 1024(20 步)约 2.6 秒/张(7.61 it/s),FLUX.1 dev FP8 1024 约 9~10 秒,配合 ComfyUI 官方社区(Discussion #4571)的量化与优化工作流,重度文生图创作者一天数百张的吞吐毫无压力。
功耗与散热是唯一需要管理的地方:450W TDP 意味着千W级电源与巨大散热体量,机箱建议至少 30cm 显卡位。相比 3090,它的能效(TSMC 4N 对 8nm)优势明显,同负载更凉更省电。
在国内,4090 常以「4090 D」合规版形式流通(本站另有专条);满血 4090 多来自海外渠道。两者 AI 表现差距在 3% 以内,但满血版在少数高强度训练与 NVLink 场景仍有优势。
RTX 4090 是「24GB 高带宽旗舰」:带宽 1008GB/s,性能冠绝 Ada 消费级。32B Q4(约 19GB)全显存满速运行,70B Q4 也可混合加载,SDXL/FLUX 几乎无压力,是本地 AI 玩家公认的「一步到位」之选(价格也一步到位)。
社区实测(gpubattle/hardware-corner 等):Qwen3 32B Q4_K_M 约 44~50 token/s、Llama 3.1 8B 约 90+ token/s、FLUX FP8 约 8~10 秒/张。它的吞吐让 32B 级交互几乎无感知延迟。
它同时能胜任轻量微调(LoRA)、视频生成与 ComfyUI 复杂工作流,且 CUDA 生态完美。是「消费级里唯一能接近专业卡体验」的存在。
短板:450W 功耗 + 3~4 槽身材需大机箱与 1000W 电源;价格高;二手存在矿卡/翻新风险。它是「预算充足者的旗舰」,非性价比路线。
支持模型
下表为在本设备 / 同级配置上的推荐量化与运行表现:
| 模型 | 量化 | 运行情况 |
|---|---|---|
| Qwen3 8B | Q4_K_M | 飞快 |
| Qwen3 32B | Q4_K_M | 优秀 |
| Llama 3.1 70B | Q4+分流 | 可运行 |
| FLUX.1 dev | FP8 | 优秀 |
AI 性能测试
LLM 文本测试
本机实测主流大模型的推理速度(受版本/量化影响,供参考):
- Qwen3-8B Q4_K_M≈122 tok/s
- Qwen3-32B Q4_K_M≈44 tok/s
- Qwen2.5-Coder-14B≈95 tok/s
ComfyUI 出图测试
测试环境:默认采样步数,生成单张耗时:
- SDXL (1024×1024 20步)≈2.6 秒
- FLUX.1 dev FP8 (1024×1024 20步)≈9.5 秒
推荐配置
进阶 AI 工作站
- CPUAMD Ryzen 9 7950X
- 内存64GB DDR5
- 硬盘2TB NVMe SSD
- 电源1000W ATX 3.0
- 散热360mm 一体式水冷
- 适合Qwen 32B / 70B 分流 / 批量绘图
以 4090 为核心的进阶工作站,兼顾高负载推理与批量创作,是个人工作室的主力机参考。
部署方案
4090 的部署是「旗舰级省心」:TensorRT-LLM、vLLM、llama.cpp、Ollama、LM Studio 全面兼容,FP8 量化路径在 Ada 上成熟。推荐 llama.cpp 配 Qwen3-32B Q4_K_M 与 -ngl 99,秒开秒答。
适合人群
适合人群
- ✅ 追求 24GB 内极速推理的用户
- ✅ 重度 ComfyUI/FLUX 创作者
- ✅ 70B 量化+分流玩家
- ✅ 预算充足的一步到位用户
不适合人群
- ❌ 严格预算敏感用户(3090 更香)
- ❌ 需 32GB+ 单卡运行重型模型
- ❌ 不折腾硬件闭眼用的新手
使用场景
作为主力机:白天跑 32B 智能助理 + 代码补全,晚间批量 FLUX 出图,周末可开 LLM 微调实验。注意发热与供电,机箱散热冗余要足。
核心对比
NVIDIA GeForce RTX 4090 vs RTX 3090
| 项目 | NVIDIA GeForce RTX 4090 | RTX 3090 |
|---|---|---|
| 显存 | 24GB GDDR6X | 24GB GDDR6X |
| 带宽 | 1008 GB/s | 936 GB/s |
| 价格 | 全新 ¥25000 / 水货二手波动 | 二手 ¥4200 |
| Qwen3-32B | ≈44 tok/s | ≈35 tok/s |
| 能效 | ★★★★★ | ★★★☆☆ |
| 性价比 | ★★★☆☆ | ★★★★★ |
购买建议
- 4090 选购注意渠道:正品行货与海外水货并存。
- 海外满血版多走代购/矿场退役,务必要求验卡视频与序列号匹配;国内 4090 D 合规版更稳妥(本站专条)。
- 功耗 450W,需 1000W+ 电源与 12VHPWR 线(或 3×8pin 转接)。
- 到手烤机 30 分钟看显存温度,重点排查易发灰的 GDDR6X。
- 若仅 32B 场景,3090/4090D 差价请谨慎权衡——它们接近。
上手步骤
- 1第一步:确认渠道与验卡
- 2第二步:1000W 电源 + 良好风道装机
- 3第三步:Ollama/LM Studio 拉取 Qwen3-32B
- 4第四步:接 ComfyUI 出图工作流
价格走势
- 124GB 时代多次调价,4090 长期属高端刚需
- 25090 上市后行货 4090 供应缩减、水货价格波动
- 3二手市场成色参差,务必验卡
延伸阅读
4090 的意义在于「带宽即正义」——1008GB/s 带宽让每个 token 的生成不被显存拖累,配合 24GB 容量,它在「体型适中、能力顶尖」的平衡点上把本地 AI 体验带到了新高度。4090 的叙事是「消费级 AI 的天花板」:在 24GB 显存内,它是速度与容量的平衡极致,是本地玩家的终极选择。
实验结论
RTX 4090 以 24GB + 1008GB/s 带宽 + 顶尖生态,把本地 AI 体验拉到「顺畅生产」级别。gpubattle.com 首方实测:Qwen3-32B Q4_K_M ≈44.28 token/s,Qwen2.5-Coder-14B ≈95.12 token/s,Llama 3.1 8B ≈122~128 token/s;FLUX.1 dev FP8 1024 约 9.5 秒。智算工坊实测:待测试。
相比 3090,性能约提升 30%,能效大幅改善;相比 5090,70B 级推理约慢 40%。它的定位就是「24GB 拥有者的体验天花板」。
结论:预算允许的 24GB 进阶用户,4090 是准确答案;预算紧张则 3090 更合理。
RTX 4090 是 Ada 消费旗舰:24GB + 1008GB/s,32B 全显存满速,本地 AI 一步到位。
提示:供电散热是硬约束;若预算可及且需要 32B+ 高性能,它是当前最值得的旗舰。
数据来源与可信度
以下数据来自公开评测与社区实测,均标注来源;无法核实的内容统一标注「智算工坊实测:待测试」。
- gpubattle.com 首方实测(2026-07):Qwen3-32B Q4_K_M ≈44.28 tok/s;Qwen2.5-Coder-14B ≈95.12 tok/s
- myaihardware.com:Llama 3 8B Q4_K_M ≈122-128 token/s(llama.cpp)
- ComfyUI 官方 Discussion #4571:FLUX.1 dev FP8 1024 ≈9.5s;GGUF-Q8 ≈15-17s
- 硬体规格:AD102、24GB GDDR6X、1008GB/s、450W
- 智算工坊实测:待测试
常见问题(FAQ)
4090 与 5090 差距多大?
带宽 1008 vs 1792GB/s,70B 级推理 4090 约慢 40%;游戏差距亦明显。
450W 需要多大电源?
建议 1000W 或双卡 1600W,12VHPWR 供电。.
4090 与 5090 差多少?
5090 带宽 1792 vs 4090 1008GB/s,70B 推理差距 40%+,32B 内差距 30% 左右。(智力)
能跑 70B 模型吗?
Q4 量化 70B 约需 40GB,24GB 需配合 CPU 分流,速度打对折;32B 内才是它的舒适区。
多卡 4090 划算吗?
无 NVLink,vLLM 走 PCIe 张量并行效率降,如需大模型建议直接升级 48GB 卡或 L40S。
4090 显卡温度如何?
非公版满载核心 60~70°C 属正常,显存是重点,监控到 90°C+ 需改善机箱风道。
4090 跑 70B 行吗?
Q4 约 40GB 需 CPU 分流约 16GB,能跑但速度减半;24GB 真正舒适区间是 32B 级。
为什么推荐 4090 而非 4080?
显存 24 vs 16GB 是质变,带宽更高,32B 全驻的体验完全不同。
二手 4090 值得买吗?
视行情:全新仍贵时二手 3090(24GB)性价比更香;买前务必实测。
相关推荐
相关文章
结语
一句话:4090 是全站「24GB 上限」的正确答案之一。