ComfyUI 提示词完全指南:权重语法、模板结构与出图调优
ComfyUI 提示词完全指南:权重语法、模板结构与出图调优很多人把 ComfyUI 的提示词当关键词堆砌:best quality, masterpiece, 1girl, blue hair...。堆是堆得出来,但人物、动作、背景全混在一起,改一处动全身。这篇文章拆解提示词的语法规则和结构模板,让你写出来的提示词「指哪打哪」。 一、先分清:ComfyUI 用的是什么提示词ComfyUI 本身不产出提示词语法,它只是把提示词交给背后的模型(Stable Diffusion、Flux、SDXL、Wan 等)。所以要掌握两套东西: ComfyUI 工作流里怎么写:正负提示词各放哪个节点(CLIP Text Encode)、加权怎么写; 模型认什么语法:SD 1.5 / SDXL / Flux 对提示词的理解差异很大。 本文默认以最主流的 Stable Diffusion / SDXL 生态为例,Flux 的特殊之处会在最后单独讲。 在开始之前,先建立一个重要的认知:提示词是写给「文本编码器」看的,不是写给「扩散模型」看的。SD 的 CLIP ...
llama.cpp 分层 Offload:低显存显卡也能跑大模型
llama.cpp 分层 Offload:低显存显卡也能跑大模型llama.cpp 是 GGUF 推理的元老,它的分层 Offload 能把模型按层拆开,一部分放显存、一部分放内存,让 8GB 甚至 6GB 的显卡也能带动 14B 模型。这篇文章从原理讲到实操参数,附实测数据。 一、为什么要分层 Offload先回顾一下显存换算公式:14B 模型用 Q4_K_M 大约要 10GB 显存。如果你的显卡只有 8GB,直接整模型扔进显存装不下,程序直接报 OOM。 传统思路是「全 CPU 跑」:不占显存,但纯 CPU 推理慢得让人怀疑人生——7B 模型在主流 CPU 上大概只有 3~6 token/s,做个翻译都要等半天。 llama.cpp 给了第三条路:分层(Layer Offload)。大模型的 Transformer 结构是一层层堆叠的,每一层都是「Attention + FFN」。既然装不下全部,就装一部分:把前 N 层放 GPU,剩下的层放 CPU,推理时每层算完把结果传给下一层,GPU 和 CPU 协同工作。 这样做的核心收益:显存不够时,用一部分 CPU 计...
Ollama 量化与显存规划指南:用公式算出你的显卡能跑多大的模型
Ollama 量化与显存规划指南Ollama 拉模型很方便,但「该拉多大、选什么量化」没人替你算:这篇文章把显存换算公式、量化档位怎么选、装不下怎么办一次讲清楚,让你买显卡前就能算出能不能跑。 一、先搞懂模型大小:参数不是体积很多人把「7B 模型」理解成 7GB,这是最大的误区。B 是 Billion(十亿),7B 表示模型有 70 亿个参数。参数只是神经元数量,真正占空间的,是这些参数「用什么精度存」。 模型权重的原始精度是 FP16(半精度),每个参数占 2 字节。所以一个 7B 模型的原始体积是: 17B × 2 字节 ≈ 14GB 这还只是权重,跑起来还要算上 KV Cache(键值缓存)和运行时开销。所以「7B 模型要 14GB 显存」的说法,指的是 FP16 原版。绝大多数人用的是量化版,体积小得多,这也是 Ollama 默认帮你做的事。 为什么 Ollama 会默认用量化?因为对普通用户来说,「体积小、能装进显存、速度够快」比「理论上更准的那几个百分点」重要得多。官方库里的标签如 qwen3:8b,拉下来基本都是 Q4_K_M,体积 4.9GB 左右,8GB 显...
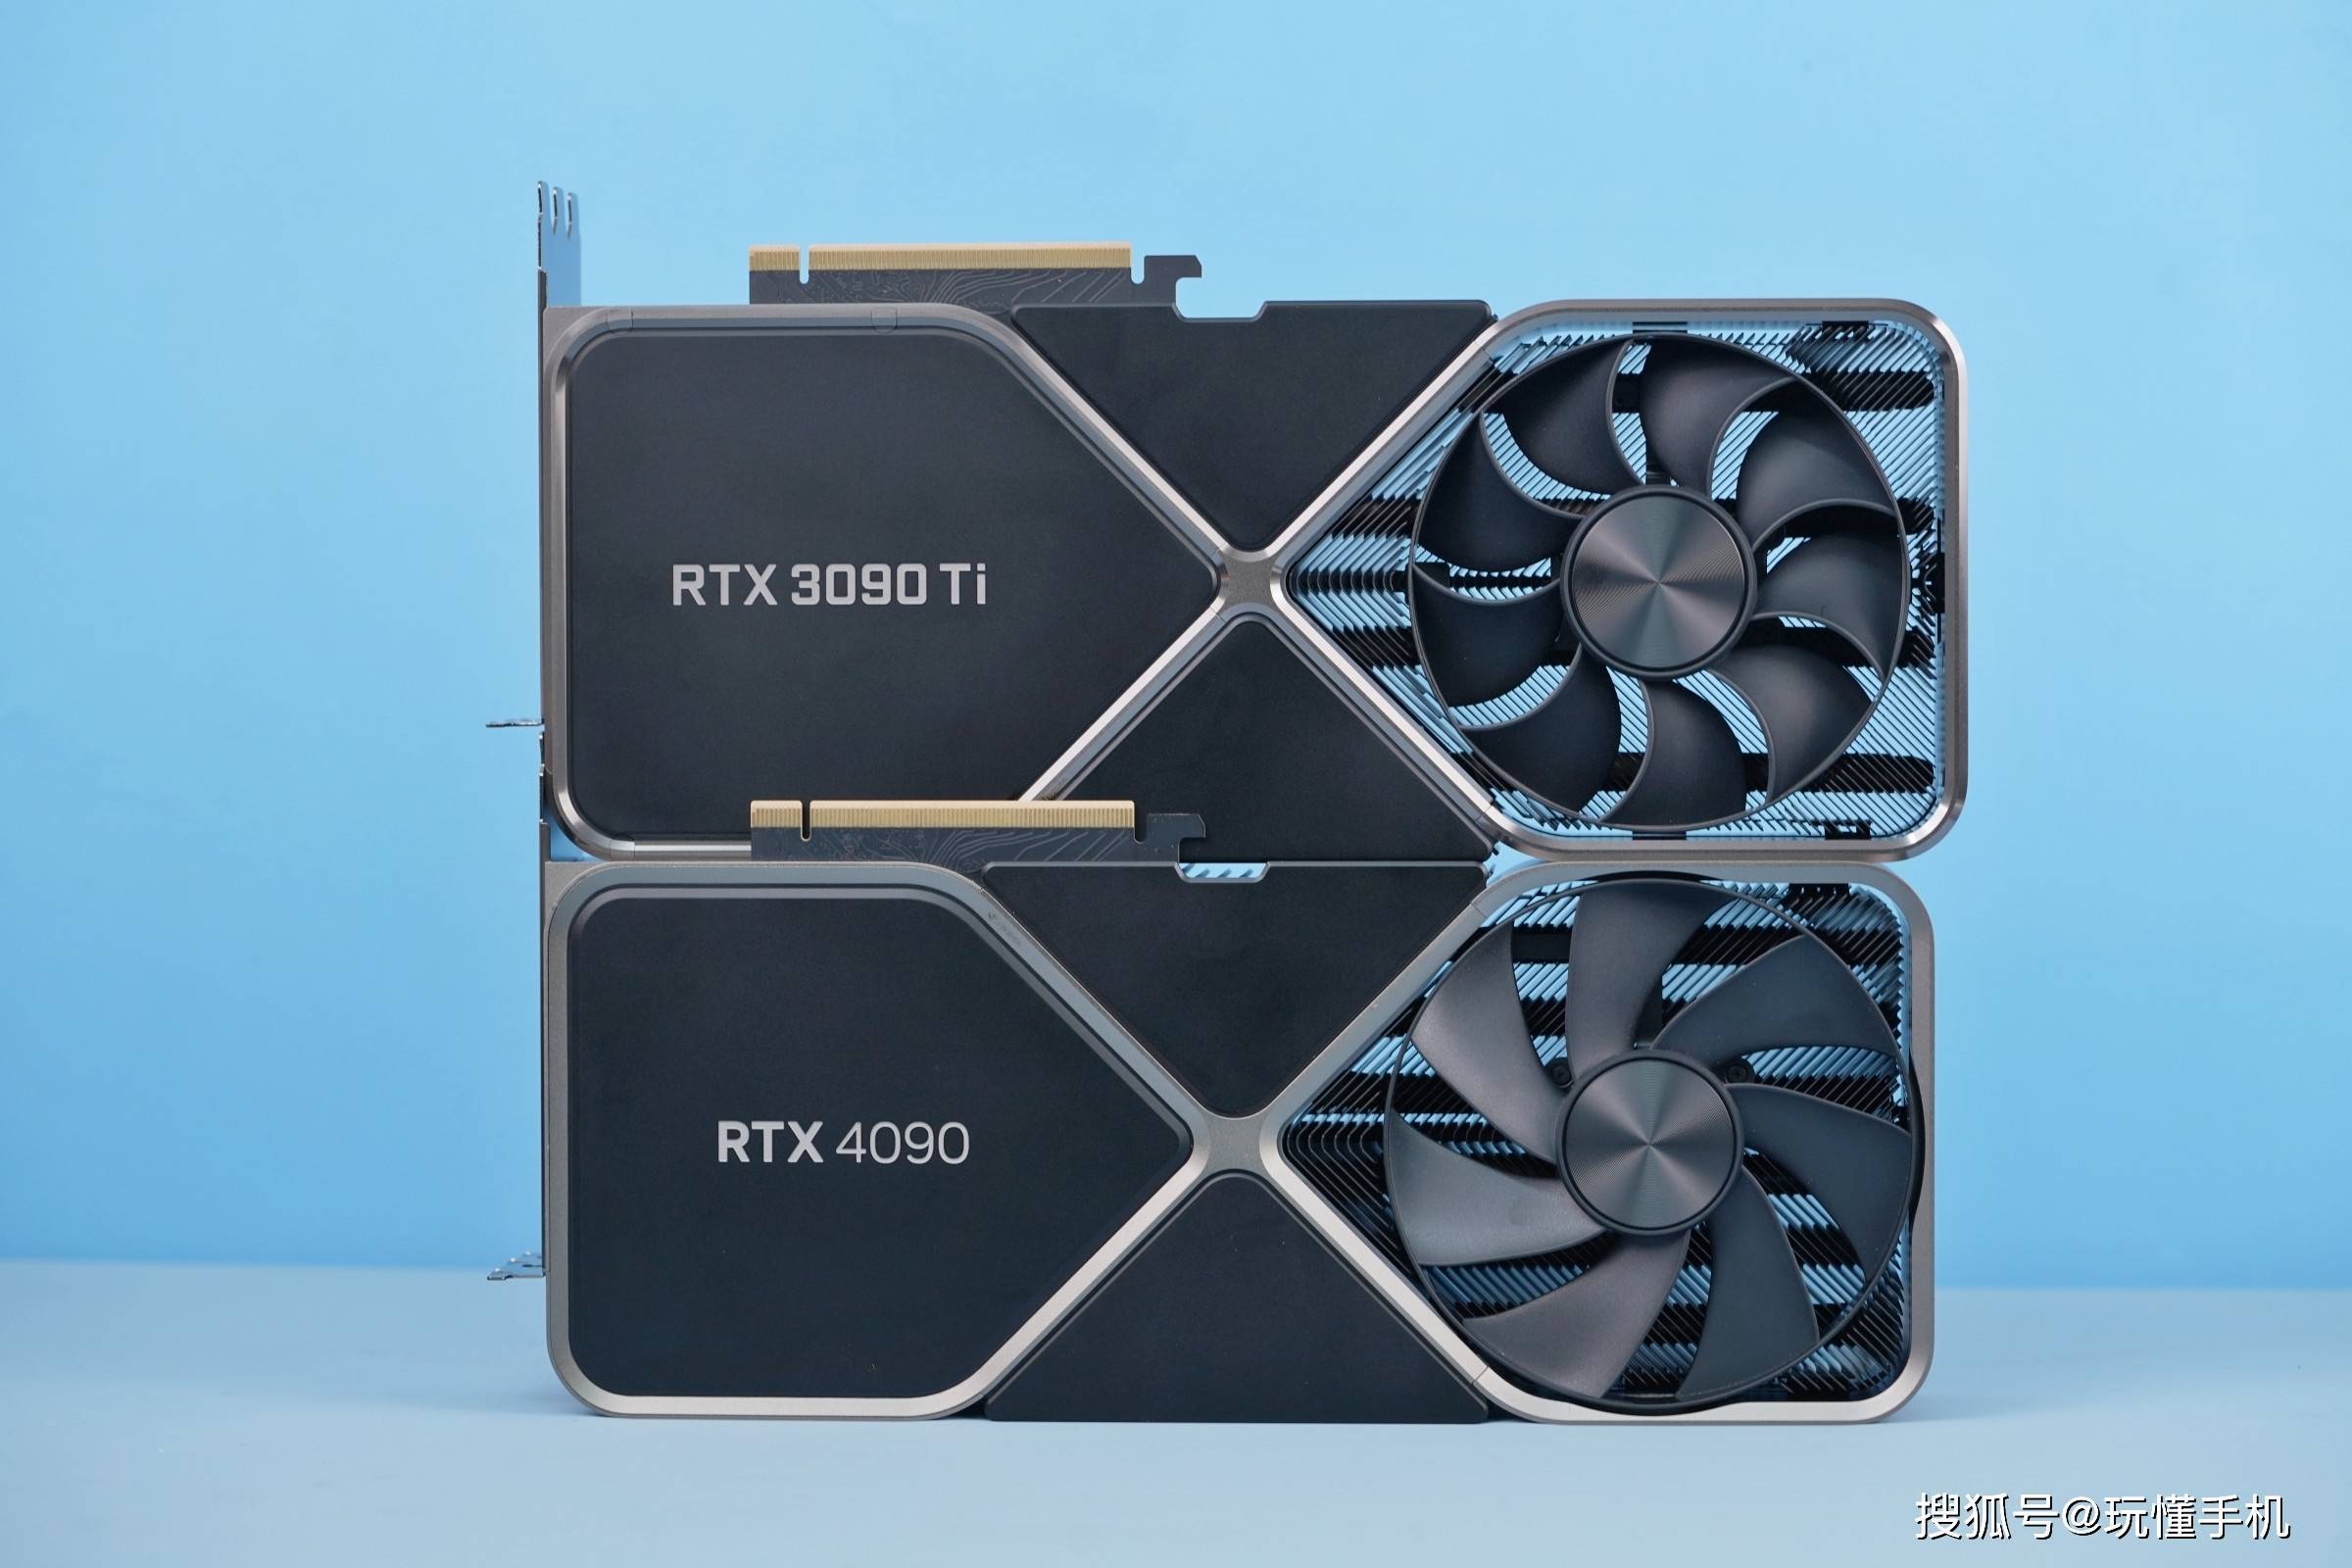
RTX 3090 运行 Qwen 模型测试:7B / 14B / 32B 实测
RTX 3090 运行 Qwen 模型测试RTX 3090 拥有 24GB 显存与 936 GB/s 带宽,是「本地跑大模型」的性价比甜点卡。本文实测它在 Qwen 系列 7B / 14B / 32B(MoE)上的推理速度、显存占用与使用体验,给同样用 3090 的朋友一个参考。 测试环境 项目 配置 显卡 NVIDIA RTX 3090 24GB 驱动 560.94 工具 Ollama 0.5.3 / llama.cpp b4000 模型 Qwen3 8B、Qwen3 14B、Qwen3 30B-A3B(MoE) 量化 Q4_K_M / Q5_K_M 一、显存占用实测 模型 量化 显存占用 能否全量 offload Qwen3 8B Q4_K_M 约 6.2GB ✅ 轻松 Qwen3 14B Q4_K_M 约 9.8GB ✅ 轻松 Qwen3 14B Q5_K_M 约 11.5GB ✅ 可以 Qwen3 30B-A3B(MoE) Q4_K_M 约 18.5GB ✅ 可以 Qwen3 32B ...
Qwen3 本地部署完整教程:从下载到跑通全流程
Qwen3 本地部署完整教程Qwen(通义千问)是国产开源模型里生态最完整、中文能力最强的一个系列。本教程带你把 Qwen3 从「下载」到「本地跑通」,覆盖 Ollama、llama.cpp、LM Studio 三条主流路线,并附常见问题排查。 一、准备工作:确认你的硬件 模型规模 量化 显存需求 推荐显卡 Qwen3 0.6B Q4 约 1GB 任意 4GB 显卡 / 纯 CPU Qwen3 4B Q4 约 3GB RTX 3060 12G 起步 Qwen3 8B Q4 约 6GB RTX 3060 12G Qwen3 14B Q4 约 10GB RTX 4080 / 4090 Qwen3 30B-A3B(MoE) Q4 约 18GB RTX 4090 24G Qwen3 32B Q4 约 20GB RTX 4090 / 双卡 Qwen3 72B Q4 约 45GB 双卡 / 服务器 > 没有独显也能跑:Qwen3 0.6B~4B 用 CPU 推理,速度较慢但可用。 二、路线一:Ollama 一键运行(推荐新手)Ollama 是本地运行 ...
ComfyUI 部署与工作流:节点式 AI 绘画
ComfyUI 部署与工作流ComfyUI 是基于 Stable Diffusion 的节点式 AI 绘画工具,以灵活、可控著称:每个处理步骤都是一个节点,连线即可搭建复杂生成流程,是专业 AI 绘画的首选。 一、环境要求 GPU:NVIDIA 显卡,显存 ≥ 8GB(推荐 12GB+) 系统:Windows / Linux / macOS Python:3.10+(自带环境) 二、安装部署方式一:一键整合包(推荐新手)下载秋叶/星空等社区整合包,解压即用,自带模型与环境。 方式二:源码部署1git clone https://github.com/comfyanonymous/ComfyUI.gitcd ComfyUI# 创建虚拟环境python -m venv venvsource venv/bin/activate# 安装依赖pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121pip install -r ...
LM Studio 本地部署入门:图形化界面,小白友好
LM Studio 本地部署入门如果你不想碰命令行,LM Studio 是本地运行大模型最友好的选择:全图形化界面,下载模型、聊天对话、本地 API 服务,全部鼠标点点就能完成。 一、安装 前往 https://lmstudio.ai 下载对应系统安装包(Windows / macOS / Linux) 双击安装,首次启动会提示选择模型目录(默认 ~/.lmstudio) 二、下载模型 左侧边栏点击「🔍 搜索」图标 在搜索框输入模型名(如 qwen2.5、llama 3.1) 选择量化版本:显存不够选 Q4_K_M(体积/质量平衡),显存充足可选 Q6/Q8 点击「Download」等待完成 模型在 Hugging Face 下载,若速度慢可在「Settings → Hobby」配置镜像(hf-mirror.com)。 三、开始对话 左侧「💬 聊天」图标 顶部选择已下载的模型 右侧可调节参数: Temperature:越低越严谨,越高越有创造性(默认 0.7) Max Tokens:最大回复长度 Conte...
vLLM 部署与性能调优:高并发推理的正确姿势
vLLM 部署与性能调优Ollama 适合个人使用,但当你要对外提供服务、支撑高并发时,vLLM 是业界主流选择。它通过 PagedAttention、Continuous Batching 等优化,吞吐量可达传统方案的 10~20 倍。 一、环境要求 GPU:NVIDIA 显卡(Ampere 架构以上最佳),显存 ≥ 16GB 系统:Linux(推荐 Ubuntu 22.04+),CUDA 12.x Python:3.10+ 二、安装 vLLM1# 方式一:pip 安装pip install vllm# 方式二:Docker(推荐生产环境)docker pull vllm/vllm-openai:latest 三、启动服务方式一:命令行1python -m vllm.entrypoints.openai.api_server \ --model Qwen/Qwen2.5-7B-Instruct \ --served-model-name qwen2.5 \ --port 8000 \ --max-model-len 8192 \ --gpu-memory-utili...
Ollama 本地部署大模型指南:一条命令跑通 Llama / Qwen
Ollama 本地部署大模型指南Ollama 是目前最流行的本地大模型运行工具:支持 macOS / Linux / Windows,一条命令即可下载并运行 Llama、Qwen、DeepSeek 等开源模型,无需写代码。 一、安装 OllamamacOS1brew install ollama# 或官网下载 .dmg 安装包 Linux1curl -fsSL https://ollama.com/install.sh | sh Windows官网下载安装包,或使用 WSL2:wsl --install 后在 WSL 中执行 Linux 命令。 二、下载并运行模型常用模型1ollama run llama3.1:8b # Llama 3.1 8Bollama run qwen2.5:7b # 通义千问 2.5ollama run deepseek-r1:7b # DeepSeek R1 推理模型ollama run qwen2.5-coder:7b # 代码模型 首次运行会自动下载(8B 模型约 4.7GB),之后可直接对话: 1>>>...
AI 外包接单可行性报告:个人开发者如何靠 AI 赚钱
AI 外包接单可行性报告外包接单是个人开发者最常见的「用 AI 赚钱」方式:帮企业做 AI 应用、自动化流程、模型部署,按项目收费。本报告测算这条路的真实收益与门槛。 一、市场需求企业对 AI 的需求正从「了解」转向「落地」: 中小企业想上 AI 但没技术团队 → 需要外包 传统软件公司接单后缺 AI 能力 → 转包给个人 政务/国企私有化部署需求爆发 → 需要本地化交付 典型订单类型: 类型 客单价 周期 智能客服/知识库搭建 1~5 万 1~2 周 RAG 文档问答系统 2~8 万 2~4 周 模型私有化部署 3~10 万 1~3 周 Agent 自动化流程 3~15 万 2~6 周 AI 数字人直播间搭建 1~3 万 1~2 周 二、成本与收益测算个人接单(年收入模型) 平均客单价 3 万,一年交付 12~15 单 毛利:软件类外包毛利 60~80%(主要是时间成本) 年收入区间:30~60 万(单人) 关键变量:获客能力、交付效率、复购率 成本项 项目 年成本 云服务器/GPU 5000~2000...