Qwen3 各档显卡实测:4B 到 32B 该配什么显卡
Qwen3 各档显卡实测:4B 到 32B 该配什么显卡
Qwen3 是目前中文用户本地部署的首选模型家族,从 4B 到 32B(还有 MoE 的 30B-A3B)覆盖了 6GB 到 48GB 全部显存档位。这篇用多张显卡实测 Qwen3 各档模型的速度、显存与体验,直接给你一张「显卡 × 模型」对照表。
一、测试环境与方法
| 项目 | 配置 |
|---|---|
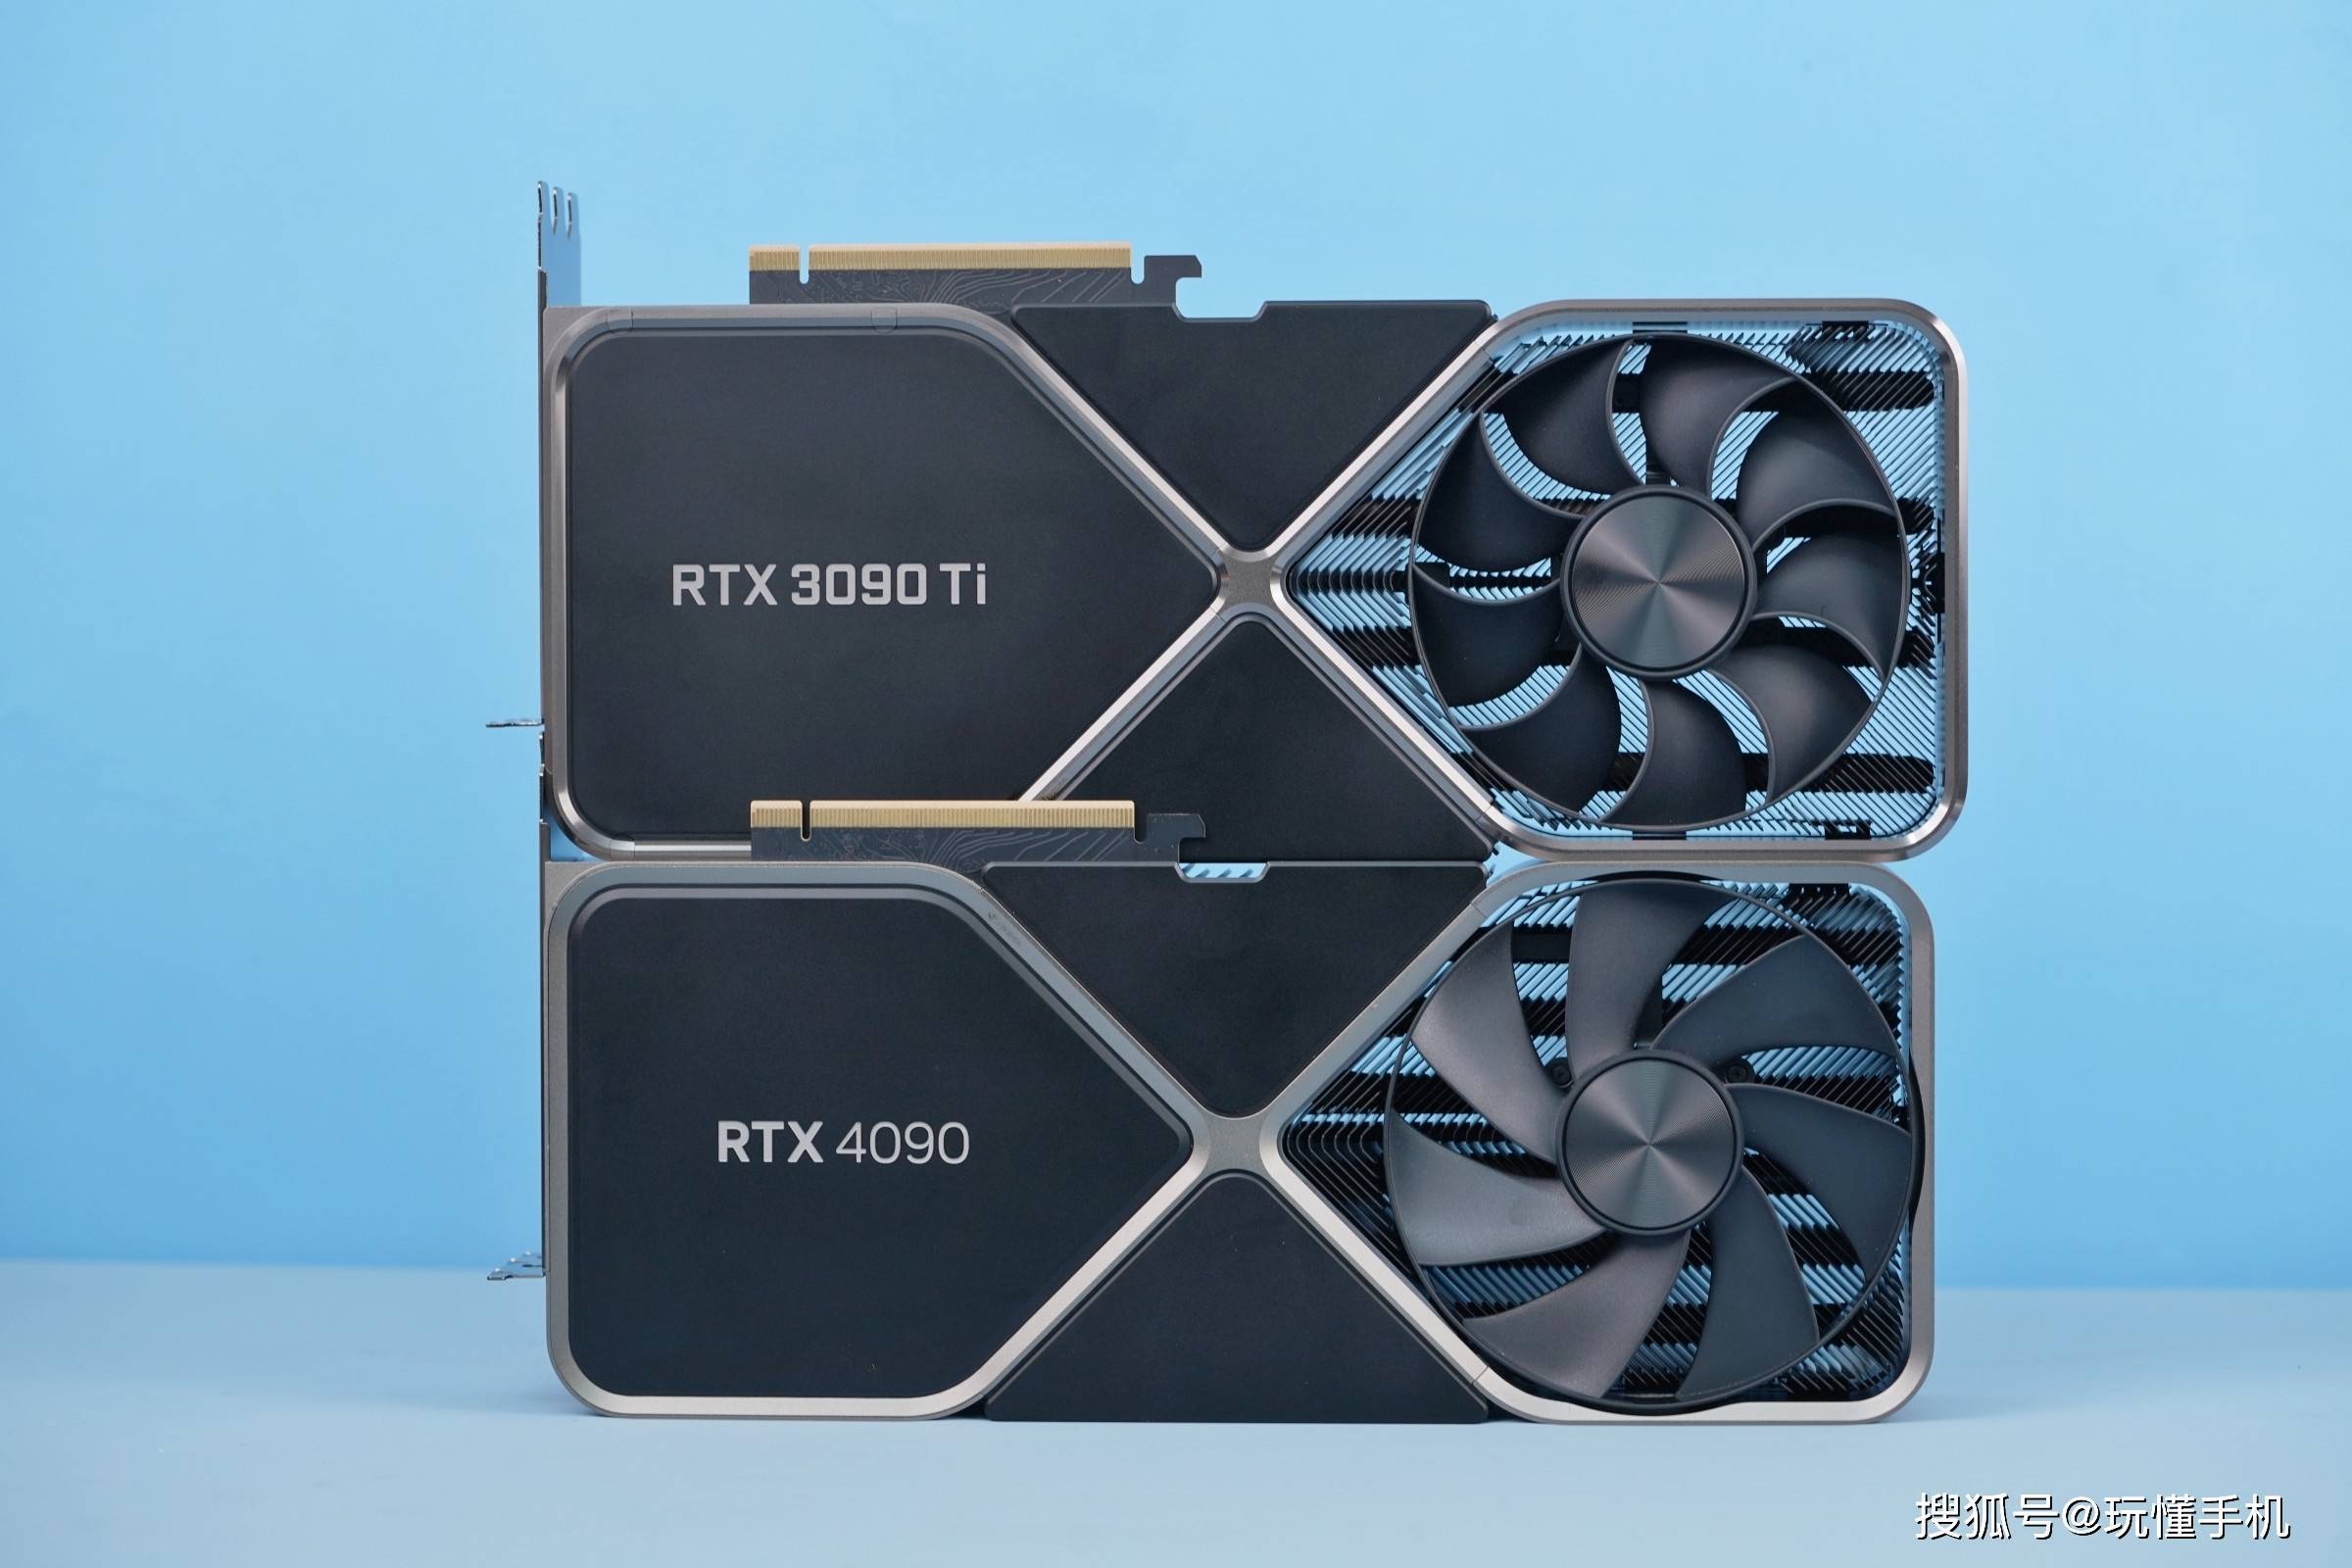
| 显卡 | RTX 3060 12G / RTX 4060 8G / RTX 3090 24G / RTX 4090 24G |
| 工具 | Ollama / llama.cpp,统一用适配显卡的配置 |
| 驱动 | 统一 560.94 |
| 模型 | Qwen3 4B、8B、14B、30B-A3B(MoE)、32B |
| 量化 | Q4_K_M(MoE 用 Q4) |
| 上下文 | 8K(与日常使用一致) |
测试方法补充
速度测试统一用固定长度的中文问答(约 500 token 输出),取稳定输出段的平均值,排除首 token 延迟的影响。显存占用记录「模型加载完成 + 一轮完整对话结束」后的稳态值,而不是峰值——峰值往往来自预填充阶段,稳态值更贴近日常体验。数据供横向对比使用,不同机器、驱动、量化版本会有 ±10% 浮动,属正常现象。
另外要说明的是:Qwen3 家族不止这五个型号。同档还有 Coder 系列(专注代码)、Turbo 系列(追求速度)等变体,显存占用和 4B/8B/14B 同档基本一致,可以按用途替换。本文以基础型号为基准,方便对照显存档位。
二、核心数据表
显存占用(Q4_K_M)
| 模型 | 体积 | 显存占用 | 装得下的显存 |
|---|---|---|---|
| Qwen3 4B | 2.5GB | 3.6GB | 6GB 及以上 |
| Qwen3 8B | 4.9GB | 6.2GB | 8GB 及以上 |
| Qwen3 14B | 8.2GB | 9.8GB | 12GB 及以上 |
| Qwen3 30B-A3B(MoE) | 14GB | 18.5GB | 24GB 及以上 |
| Qwen3 32B | 18GB | 20.5GB | 24GB(极限) |
各显卡跑各模型的输出速度(token/s)
| 模型 | 3060 12G | 4060 8G | 3090 24G | 4090 24G |
|---|---|---|---|---|
| Qwen3 4B | 约 48 | 约 55 | 约 62 | 约 75 |
| Qwen3 8B | 约 30 | 约 38 | 约 42 | 约 55 |
| Qwen3 14B | 约 18 | — | 约 26 | 约 34 |
| Qwen3 30B-A3B | — | — | 约 30 | 约 40 |
| Qwen3 32B | — | — | 约 17 | 约 23 |
(「—」表示该显卡装不下模型整进显存,见表二。)
提示:8B 是全部四张卡都能跑的「通用档」,速度从 30 ~ 55 token/s。40 token/s 以上在对话中基本感知不到等待,属于「舒适区」。
读这张表时还有一个容易忽略的点:显存和速度不是同一个量级的瓶颈。显存决定「能不能跑」,速度决定「跑得爽不爽」。3060 12G 能跑 14B(18 token/s),但速度只是「能用」级别;4090 跑同样的 14B(34 token/s)就接近「流畅」。所以「12GB 能上 14B」和「24GB 跑 14B 很爽」是两种完全不同的体验,选卡时要把「舒适度」和「能否运行」分开考虑。
为什么 4B 在低端卡上反而快不了太多
一个反直觉的数据:4B 在 3060 12G 上是 48 token/s,在 4090 上是 75 token/s——只差了 1.5 倍,远小于 8B 的 55/30≈1.8 倍或 14B 的 34/18≈1.9 倍。原因是:模型越小,单次计算量越低,显存带宽等「固定开销」占比越高,高端卡的算力优势被稀释。所以「小模型配高端卡」的性价比很差——你多花的钱买不到对等的速度提升。反过来也说明:追求 40+ token/s 不必上顶级卡,一张 8GB 卡跑 4B/8B 就够了。
三、逐档结论
6GB(GTX 1660 / 3060 Laptop)
天花板是 Qwen3 4B:完整进显存,约 48 token/s,日常对话、翻译、简单问答足够。8B 需要分层 offload 或 Q2 量化才能挤进,属于「能跑但别扭」。
8GB(RTX 4060 / 3070)
Qwen3 8B 是甜点:完整进显存,38~55 token/s,速度完全够用。8B 的代码和中文质量已经比 4B 高一个档次。14B 装不下 8GB,需要降量化或分层 offload。
12GB(RTX 3060 / 4070)
Qwen3 14B 完整进显存,约 18~26 token/s。12GB 正好卡在「14B Q4 大约 9.8GB + 8K 上下文」的边界,日常稳定。这也是 12GB 显卡最有性价比的型号选择。
如果 12GB 显卡跑 14B 偶尔因长对话显存吃紧,两个立竿见影的微调:一是把上下文从 8K 收到 4K(对话仍然够用,KV Cache 省 1~2GB);二是用 Q5 换 Q4 之类维持原档位不动,而是确保「完整进显存」优先。12GB 的体验曲线是「14B Q4 全量」最舒服,再往上(14B Q5、32B 分层)就开始别扭了。
24GB(RTX 3090 / 4090)
一手 8B/14B,一手 30B-A3B(MoE)。24GB 是「大而全」的档位:
8B:42~55 token/s,丝滑;
14B:26~34 token/s,稳;
30B-A3B:约 30~40 token/s——总参 30B 但只激活 3B,速度逼近 8B,综合能力接近 30B 稠密模型,是 24GB 的「性价比黑马」;
32B:17~23 token/s,能跑但属于舒适区边缘,长对话建议让位给 30B-A3B。
各档模型的「舒适速度线」
速度感知是很主观的东西,但有一条经验线可以参考:40 token/s 以上几乎无感,2040 有轻微等待但可接受,1520 开始有点熬人,15 以下基本放弃长对话。按这条线反推:
| 目标速度 | 3060 12G 可选 | 3090 24G 可选 | 4090 24G 可选 |
|---|---|---|---|
| 40+ token/s | 4B | 4B / 8B | 4B / 8B |
| 25~40 | 8B | 14B / 30B-A3B | 14B / 30B-A3B |
| 15~25 | 14B | 32B | 32B |
这张表的价值在于:它告诉你「这台显卡跑这个模型,体验具体是什么档」。买卡前对照自己的忍受度,比看「能不能跑」这种模糊说法直观得多。
四、MoE 的独特优势:30B-A3B 为什么值得买卡的人注意
Qwen3 30B-A3B 是混合专家模型:总参数 30B(要占 18.5GB 显存),但每次推理只激活 3B 参数的专家网络。这带来一个反直觉的结果——它占的显存接近 32B,速度却接近 8B。
对比(24GB 显卡):
| 模型 | 显存 | 速度 | 综合能力 |
|---|---|---|---|
| Qwen3 8B | 6.2GB | 42 | 中 |
| Qwen3 14B | 9.8GB | 26 | 中高 |
| Qwen3 30B-A3B | 18.5GB | 30 | 高 |
| Qwen3 32B | 20.5GB | 17 | 最高 |
MoE 模型是「显存换速度」的典型:你付出的代价是显存,换来的是大模型的能力 + 小模型的速度。24GB 显卡想兼顾「能力」和「速度」,30B-A3B 就是答案。8~16GB 档位暂时没有合适的 Qwen3 MoE(通常 Qwen/Qwen2-MoE 需要 24GB+),所以小显存用户还是看稠密模型。
MoE 的适用边界
虽然 30B-A3B 很香,但也要清醒认识它的边界:
显存是硬门槛:18.5GB 的占用决定了 24GB 显卡是它的起点,16GB 显卡装不下(需分层 offload,体验打折);
长上下文场景:MoE 的 KV Cache 和激活参数都随着上下文增长,超长对话时它的速度优势会被预填充开销稀释——短轮次问答是它的主场,超长文档分析不如稠密 14B 从容;
任务类型差异:多步骤复杂推理(代码重构、深度分析)上,MoE 的「浅层专家切换」偶尔不如同参数量稠密模型的「深度思考」稳定。
结论:30B-A3B 是「日常问答、摘要、翻译」的甜点,重活(复杂代码、长文档)用 14B 或 32B 更稳。这也是建议「24GB 显卡常驻 2~3 个模型、按任务切换」的原因。
五、超出显卡上限怎么办
显存不够的情况(比如 8GB 想跑 14B),优先级递进:
降量化:Q4_K_M → Q3 → Q2,14B 能压到 7GB 左右,质量牺牲肉眼可见但能跑;
缩上下文:8K → 2K,省出 KV Cache 的显存;
分层 offload:一部分层放 GPU,一部分放 CPU(详见 llama.cpp 分层文章),速度打折但有得用。
提示:显存不够时最该警惕的不是「慢」,而是 OOM 崩溃。换策略前先
nvidia-smi看实际空闲显存,别按标称显存规划。
显存不够时的实操检查清单
nvidia-smi查看空闲显存(别信任务管理器的「共享内存」虚高数字);ollama ps查看是否有别的模型占着显存,跑完就ollama stop释放;估算目标模型的 Q4 体积(参数量 × 0.6 GB/10B),对比空闲显存;
差 1~2GB:先缩上下文(8K→2K);
差 3~5GB:降量化(Q4→Q3);
差更多:分层 offload 或换小模型。
这套清单按「改动成本从低到高」排序,每步都要跑一轮验证,确认够用就停——别过度优化,够用就好。
六、选购建议总结
只聊天、预算紧(6GB):买 4B 跑 Qwen3 4B,或考虑二手 12GB 卡上 8B;
主流玩家(8GB):Qwen3 8B 是确定的选择,12GB 往上体验更好;
性价比(12GB):Qwen3 14B 完整进显存,综合性价比最高;
生产力(24GB):3090 / 4090 直接 30B-A3B,速度与能力兼得;
大厂/服务器(48GB+):32B 或更大模型无压力,还能上 vLLM 跑并发。
二手显卡的性价比分析
聊到显卡避不开二手市场,给几档务实建议(2026 年行情参考):
| 目标 | 推荐卡 | 入手价参考 | 能跑的 Qwen3 |
|---|---|---|---|
| 入门 | 二手 RTX 3060 12G | 低 | 8B / 14B |
| 甜点 | 二手 RTX 3090 24G | 中 | 全系(含 30B-A3B) |
| 高端 | RTX 4090 / 二手 3090 双卡 | 高 | 全系更快 / 并行 |
核心结论:本地 AI 场景,二手 3090 的「显存/价格比」依然无敌——24GB 显存、能跑全系 Qwen3,性价比远超同价位新品。3060 12G 是预算受限时的实惠选择。买二手注意三件事:显存温度正常(<100°C)、甜甜圈测试 10 分钟不黑屏、确认没有挖矿改过散热。
七、常见问题速答
Q:4B 和 8B 差别到底多大?
4B 日常聊天、翻译、简单问答够用,但代码、长文写作、复杂推理明显力不从心;8B 是「能干活」的入门线。预算允许,8B 是最低建议档——4B 适合「尝尝本地大模型」或超低配机器。
Q:为什么 4090 和 3090 同为 24GB,速度差 30%?
显存一样不代表算力一样。4090 的 CUDA 核心、内存带宽、算力都高于 3090,生成速度自然更快。但「能跑多大模型」由显存决定,两者相同——所以省钱选 3090,追求速度上 4090。
Q:32B 在 24GB 上到底能不能日常用?
能跑,但 17~23 token/s 属于「能接受但长对话熬人」的档位。日常简单问答可以,经常长对话建议用 30B-A3B 替代——体验好得多。
Q:Mac 用户怎么办?
Qwen3 同样支持 Apple Silicon(见本站 Apple Silicon 指南)。M 系列 16GB 内存跑 8B 流畅,32GB 可以上 14B。速度受限于内存带宽,但胜在「显存=内存」的容量优势。
Q:这些数字是标准答案吗?
不是。不同驱动、量化版本、上下文设置都会影响 ±10% 甚至更多。把它当作「选型参考」,别当作「性能承诺」——买卡前跑一次自己的场景最靠谱。
小结
Qwen3 从 4B 到 32B 像筛子一样,把市场分得清清楚楚:6GB 玩 4B,8GB 玩 8B,12GB 上 14B,24GB 直接 MoE 的 30B-A3B 起飞。选卡先看模型,选错模型再好的显卡也白搭——先定要跑的模型,再倒推显卡档位,顺序反了容易多花冤枉钱。
最后再强调本文最核心的三个判断:一是显存决定「能不能跑」、速度决定「跑得爽不爽」,别混淆;二是 MoE 的 30B-A3B 是 24GB 显卡的隐藏答案,日常问答用它、重活用稠密 14B/32B;三是二手 3090 的显存/价格比依然无敌,本地 AI 玩家值得认真考虑。把这些想清楚,配出来的机器既不会浪费钱,也不会卡在「跑不动」的尴尬上。对照数据表选好档位后,剩下的就交给 Ollama 一条命令去跑——模型是现成的,显卡是现成的,缺的只是选型时的这点判断力。把本文的速度表收藏好,下次给朋友推荐显卡、给自己升级硬件,先对表再下单,基本不会踩坑。数据会过时,选型逻辑不会——记住「先定模型、再定显存、最后看速度」这套顺序,任何新显卡新模型出现都能自己推算。
延伸阅读: