VS Code + Continue 接入本地大模型:完全离线的 AI 编程助手
VS Code + Continue 接入本地大模型:完全离线的 AI 编程助手
代码补全和对话是本地大模型最实用的两个场景,而 VS Code 里把两者整合得最好的免费插件就是 Continue。配上 Ollama 跑 Qwen3 Coder,你的代码助手全程离线、代码不上云。这篇文章从安装到配置调优,附实测速度。
一、Continue 是什么
Continue 是 VS Code 的开源 AI 编程助手插件,对标 Copilot,但核心卖点是自由接模型:既能接 OpenAI 等云端 API,也能接本地 Ollama / llama.cpp 跑的模型。对在意代码隐私的开发者来说,本地模型 + Continue 是目前最成熟的自托管方案。
在深入之前,先搞清楚 Continue 与 Copilot 类工具的本质差异:Copilot 全家桶把模型、数据、功能都打包在一起,你只能用它内置的云端模型,代码片段会传到微软/OpenAI 的服务器;Continue 则把「模型层」完全开放——模型可以是本地的、可以是你自建的、也可以是任意云端 API。这种开放性让「代码不出本地」成为可能,也让进阶玩家能随时切换模型、对比不同厂商的代码能力。
Continue 提供两大能力:
代码补全:打字时实时预测下一段代码(Tab 接受);
对话式编程:选中代码提问、让它改 bug、生成函数,直接在编辑器内完成,带上下文引用。
这两个能力对应两种不同的模型需求:补全要「快」,对话要「强」。这个「快强分离」的思路贯穿整篇文章,也是 Continue 推荐「补全小模型、对话大模型」配置的根本原因。
二、准备工作:先把模型跑起来
Continue 自己不含模型,需要你先用 Ollama 把模型跑起来(不会看本站 Ollama 教程)。推荐配置:
1 | ollama pull qwen3-coder:30b # 代码能力最强,需 24GB 显存/32GB 内存ollama pull deepseek-coder-v2:16b # 16GB 即可,代码质量不错ollama pull qwen3-coder:8b # 8GB 显卡入门档 |
提示:代码模型选 Coder 系列(Qwen3-Coder / DeepSeek-Coder),别拿通用模型凑合。代码任务是「指令跟随」型,专门训练的 Coder 模型补全准确率明显更高。
按显存选模型
| 显存/内存 | 补全模型 | 对话模型 |
|---|---|---|
| 8GB | Qwen3-Coder 8B | Qwen3-Coder 8B |
| 16GB | Qwen3-Coder 8B | DeepSeek-Coder-V2 16B |
| 24GB | Qwen3-Coder 8B | Qwen3-Coder 30B |
| 32GB+ | Qwen3-Coder 14B | Qwen3-Coder 30B |
补全模型始终用小号(8B 足够),大号留给对话——这是延续「快强分离」思路的实践。
三、安装 Continue 并配置本地模型
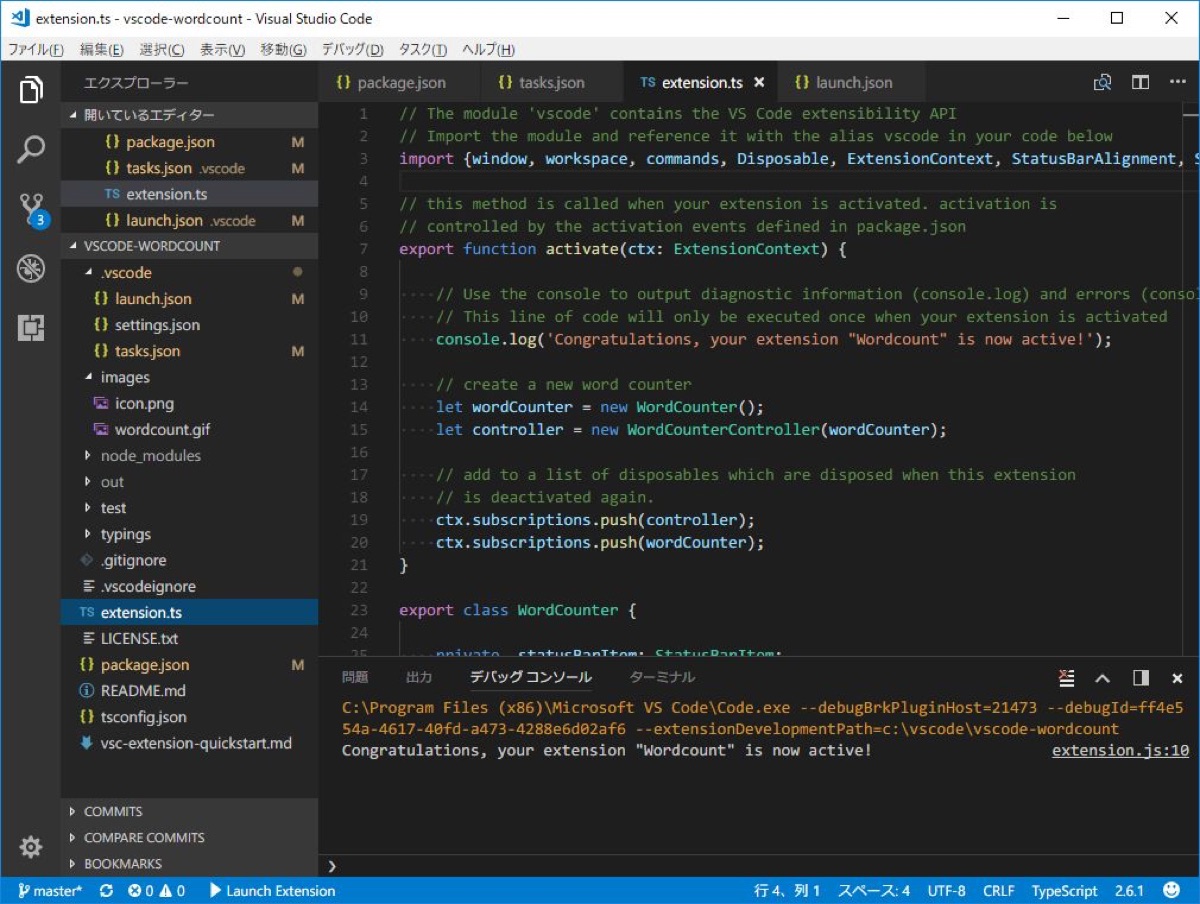
VS Code 扩展商店搜索 Continue(作者 Continue Inc.),安装后自动出现在侧边栏。
关键配置在 ~/.continue/config.yaml,这是 Continue 的核心配置,手动编辑:
1 | name: Local Setupmodels: - name: Qwen3 Coder 30B provider: ollama model: qwen3-coder:30b roles: - chat - edittabAutocompleteModel: title: Qwen3 Coder 8B provider: ollama model: qwen3-coder:8b |
配置要点:
roles:
chat(对话)、edit(编辑/改动代码)、apply(应用改动)三种角色,一个模型可以承担多种;tabAutocompleteModel:专门负责「Tab 补全」的模型。补全要低延迟,建议用一个小模型(8B),把大模型留给对话——这是 Continue 的官方推荐配置,对话和补全分开;
provider: ollama:Continue 通过 Ollama 的本地 API(默认 11434 端口)调用,无需任何 API Key。
改完配置,重启 VS Code 或执行 Continue 面板的 Reload,侧边栏选好模型即可使用。
多模型列表:一次配多个,随时切换
Continue 的 models 是一个数组,可以同时配置多个模型。建议把本地能跑的几档都配上:
1 | models: - name: Qwen3 Coder 30B provider: ollama model: qwen3-coder:30b roles: [chat, edit] - name: DeepSeek Coder V2 16B provider: ollama model: deepseek-coder-v2:16b roles: [chat] - name: Qwen3 Coder 8B provider: ollama model: qwen3-coder:8b roles: [chat] |
日常用 30B 干重活,机器忙不过来或显存紧张时切 16B / 8B 顶着,体验无缝衔接。Chat 面板右上角下拉菜单就是模型切换器。
四、实测:三种配置的速度与效果
用同一台机器测三档模型,看补全和对话的真实表现(Qwen3-Coder,Q4_K_M):
| 模型 | 显存/内存 | Tab 补全延迟 | 对话速度 | 代码质量评价 |
|---|---|---|---|---|
| Qwen3-Coder 8B | 8GB | 约 0.3s | 约 40 token/s | 够用,小函数不错 |
| DeepSeek-Coder-V2 16B | 16GB | 约 0.8s | 约 25 token/s | 明显更好,逻辑更稳 |
| Qwen3-Coder 30B | 24GB/32GB | 约 1.2s | 约 18 token/s | 最强,复杂重构靠谱 |
补充说明:补全延迟测的是「从停止输入到补全出现的间隔」,实测 8B 在 0.3 秒左右属于「无感」水平;16B 的 0.8 秒已经能感觉到轻微等待;30B 的 1.2 秒如果持续存在,会明显打断心流。这也是为什么「对话可以用 30B,补全务必用 8B」——补全对延迟的敏感度远高于对话。如果你的补全模型刚好是 16B 以上且觉得卡顿,第一时间考虑换回 8B 补全,而不是加显存。
另一个实测体会:对话模型的「代码能力」和「补全能力」是两回事。30B 对话能力很强,但让它做补全并不比 8B 好到哪去,反而慢得多。补全的本质是「预测下一 token」,模型的训练方式和上下文窗口决定了效果,大小的影响没有对话任务那么悬殊。所以再次强调:补全交给小模型,省下显存和延迟,对话质量不受任何影响。
补全延迟建议目标 < 1 秒。超过 1.5 秒大脑就断了,所以 8GB 显卡入门推荐让 8B 做补全、大模型做对话——两者互补。
提示:补全的体验跟模型是否「适配补全任务」关系极大。通用模型(非 Coder)做补全经常出现「补了一大段却不接上文」的尴尬,所以千万别用通用模型当
tabAutocompleteModel。
影响补全体验的其他因素
除了模型档位,补全体验还受这几个变量影响,值得一并排查:
上下文大小:Continue 补全时会参考当前文件前后文,Open 的标签页越多、文件越大,单次补全的推理越慢。把不相关的文件收起来,补全延迟能明显下降;
触发时机:Continue 默认「打字停顿才触发补全」,连续快速输入时它可能在等待;改完代码别急着换行,停半秒让补全跟上;
文件类型:不同语言的补全质量差异大——Python、TypeScript 这类常见语言 Coder 模型训练充分,效果好;冷门 DSL 或配置文件,补全基本靠猜,别指望太多;
键盘反应:补全出现后 Tab 接受、Esc 关闭,都是即时响应,不用等「全部输完」再确认——边写边接受,效率最高。
一个实际工作流演示
假设你正在写一个待办事项 API,用 Continue 的完整流程:
打一两行注释描述接口:「GET /todos 返回待办列表」;
Tab 接受补全出来的路由框架;
选中补全的代码,问 Continue「这个接口缺少错误处理吗」,它给出补充建议;
Ctrl+I进入 Edit 模式,输入「给这个接口加上 404 和 500 的错误处理」,应用 diff;写测试时,选中测试文件,问「根据这个接口实现生成 pytest 测试」。
一套流程下来,路由、错误处理、测试全部由本地模型辅助完成,全程代码不出机器。实测 16GB 配置(8B 补全 + 16B 对话)下,一次完整的「写接口 + 补错误处理 + 生成测试」大约 5 分钟,比手写明显快,且质量可控。
五、Continue 的高效用法
配置好后,这几个操作最常用:
1. 选中代码 → 问问题
选中一段代码,Continue 面板会自动把代码作为上下文,直接问「这段在干嘛」「怎么优化」。这是日常最高频的操作。
2. 自然语言生成
在 Continue 输入框里描述需求,比如「写一个 Python 函数,读取 CSV 并统计每列空值」,模型直接在编辑器插入代码。
3. Edit 模式改代码
Ctrl+I 打开 Edit 模式,选中代码后输入修改指令(如「改成异步实现」),模型直接在原位置给出 diff,确认后应用。
4. 用 @ 符号引用文件
Continue 支持 @文件名 把某个文件加入上下文,多文件重构时非常有用。
进阶用法
掌握基本操作后,这几个技巧能把效率再拉高一截:
Ctrl+Enter 无上下文提问:对话时按住 Ctrl 再发送,模型不会自动带上当前文件内容,适合问「和代码无关」的问题,省 token、省时间;
/commands 快捷指令:Continue 内置了
/ask、/edit、/comment等命令,比如/comment直接给选中代码生成注释,/docstring生成文档字符串,配合 Tab 键补全命令名;Codebase 索引:新版 Continue 支持项目级索引(embeddings),问「我们的项目里哪里处理了支付回调」,它能跨文件检索回答,相当于给整个代码库装了本地 RAG;
Diff 确认:Edit 模式生成改动后,VS Code 的 diff 视图会清晰展示改了哪里,逐块 Accept 比全量应用安全得多。
六、与云端 Copilot 的对比
| 维度 | Continue + 本地模型 | GitHub Copilot |
|---|---|---|
| 成本 | 免费(硬件已购) | 订阅制 |
| 代码隐私 | 完全本地 | 上传云端 |
| 模型选择 | 任意 | 锁定 |
| 补全质量 | 依赖本地模型 | 顶级模型 |
| 联网依赖 | 无 | 必须联网 |
| 定制程度 | 高 | 低 |
客观说结论:论补全的「即开即用」,Copilot 依然是天花板;但论「代码不出网 + 免费 + 可定制」,本地方案无可替代。不少团队采用混合策略:日常写非敏感代码用 Copilot,涉密项目或客户代码切到本地 Continue。两条腿走路,既保证效率又不牺牲隐私。
七、隐私与安全提醒
本地方案最大的优势是隐私,但也有几个坑要避开:
别开 Web Search:Continue 默认不联网,但如果你接了 Search 插件,代码可能外传;
模型质量与安全:本地模型输出的代码同样可能有 bug,尤其安全相关代码(SQL 拼接、鉴权)必须人工 review;
不要提交 API Key:即使本地配置,也养成不把 config.yaml 提交到 git 的习惯;
企业场景:如果公司要求代码不出网,本地方案是唯一合规解。
本地方案不等于「绝对安全」
「本地」解决的是「数据不出机器」的问题,但代码安全还有其他维度要想清楚:
模型镜像来源:从 Ollama 官方库 / 模型官方 HuggingFace 拉取,别从不明来源下模型——GGUF 文件被投毒并非天方夜谭,曾有过「伪装成模型的恶意权重」的案例;
终端与屏幕共享:本地方案的数据落在你机器上,如果机器本身中毒、或开着远程桌面,数据同样会泄露。「本地」挡的是网络层,挡不了主机层;
输出仍要审查:AI 生成的代码不是「可信代码」,尤其涉及加密、鉴权、金额计算的部分,引入前必须人工核对。把它当「高级模板」,不当「正确性保证」。
八、问题排查
| 问题 | 原因 | 对策 |
|---|---|---|
| 补全没反应 | Ollama 没起 / 模型没拉 | ollama serve 检查,ollama list 确认 |
| 对话报连接错误 | config.yaml 的 provider 写错 | 检查 provider: ollama 拼写 |
| 补全太慢 | 模型太大 | 换 8B 做补全,或关掉不必要插件 |
| 中文回答乱 | 模型不支持中文 | 换 Qwen3 系列 |
| 输出被截断 | 上下文太长 | 把 context_length 调大,或精简对话 |
几个更隐蔽的坑
配置改了没生效:Continue 的 config.yaml 有严格缩进(YAML 语法),缩进错了整个文件不识别,但 VS Code 不会报错——表现为「什么模型都没了」。改完先在任意 YAML 编辑器里校验一下语法。
补全模型加载后显存爆了:tabAutocompleteModel 用 8B 但 Ollama 还在内存里驻留其他大模型时,可能 OOM。用 ollama ps 看驻留模型,ollama stop 模型名 释放。
多项目环境变量:如果给不同项目配不同模型,可以用 Continue 的 .continue/config.yaml(项目级配置)覆盖全局配置,比如 A 项目用本地、B 项目用云端。
小结
VS Code + Continue + Ollama 是一套完全免费、完全离线的 AI 编程方案。核心配置思想是「补全用小模型、对话用大模型」,两者分开配置才能兼顾速度和效果。装上 Coder 系列模型,隐私敏感项目的编程体验直接上一个台阶。把「模型来源可信」「代码仍需审查」「配置注意 YAML 缩进」这几个点记牢,这套本地编程助手就能稳定跑很久。如果你正纠结要不要为此配一台机器,一张 16GB 显存的显卡 + 16GB 模型双配置,已经能覆盖绝大多数日常开发场景。先把 8B 补全 + 16B 对话这套组合跑起来,真实用一段时间,再决定要不要上 30B——大多数场景下,这套入门配置的体验已经超过预期。
延伸阅读: