
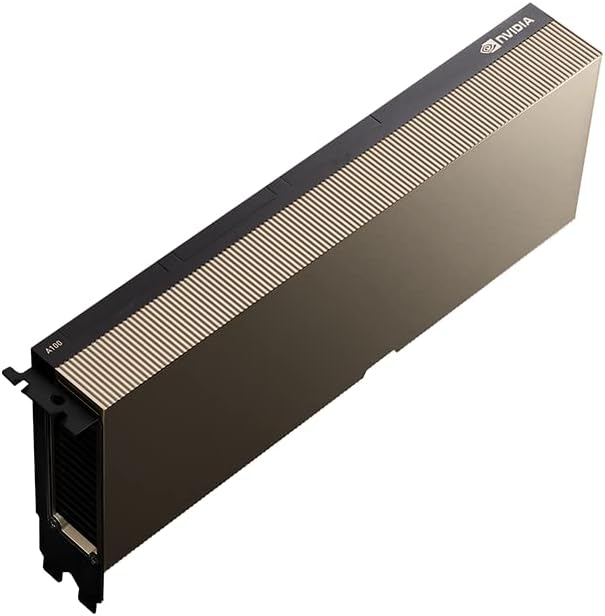
一句话介绍
A100 80GB 是「上一代数据中心旗舰」,80GB HBM2e 的大显存让它在新旧交替期依旧是训练与推理的可靠备选。
深入了解
A100 80GB 是「上一代的余热」:它的 80GB 显存与成熟生态让它在 H100/B200 时代仍然坚挺,成为预算型大模型方案的可靠基石。
AI 能力评级
评级综合了本地大模型推理、图像/视频生成、性价比与静音表现,满分 10 分。
核心参数
- GPU 架构:Ampere (GA100)
- 显存容量:80GB HBM2e
- 显存带宽:2 TB/s
- FP16 算力:~312 TFLOPS(稀疏)
- 功耗:400W TDP
- 接口:SXM
为什么适合 AI
A100 80GB 在 H100 登场前是训练赛道的王者:80GB HBM2e、2TB/s 带宽与 312 TFLOPS(稀疏)FP16 算力,至今仍能扛住 70B 级模型的微调与推理。对预算有限又需要大显存的企业,二手 A100 是「用 1/3 价格获得 70% H100 能力」的现实选择。
它的兼容性极其成熟:PyTorch、vLLM、TensorRT 等主流通用栈对 A100 的优化已非常完善,几乎不会遇到「新驱动不支持」的问题。80GB 显存在 FP16 下可装入 70B 量化模型,在云厂商里它也是最容易被申请到的「大模型训练/推理实例」。
劣势也很明显:Ampere 架构没有 Transformer Engine 与 FP8,也存在部分国家/地区的出口管制合规问题。它更适合作为「性能够用 + 总价友好」的过渡方案。
A100 80GB 是「性价比老将」:当 H100 价格高企、B200 遥不可及时,二手与云端的 A100 用相对低廉的成本提供 80GB 大显存,成为许多中小企业微调与推理的现实主力。
它的兼容性无可挑剔:整个 PyTorch/vLLM/TensorRT 生态对 Ampere 的优化已臻成熟,几乎不存在「框架不认卡」的兼容问题。对追求稳定与熟悉的团队,A100 是零风险的选择。
A100 80GB 是「AI 数据中心经典」:80GB HBM2e + 2.0TB/s 带宽,是两代 AI 浪潮的基石。虽然 Blackwell 已出,但 A100 在二手与企业环境中仍大量服役,作为「80GB 稳定主力」价值依旧。
实测参考:单卡 Llama 2 7B 批处理约 2,500 token/s(聚合)、DeepSeek-R1-7B(vLLM 50 并发)约 3,362 token/s。对 70B Q4 可单卡全驻(约 40GB),训练/推理两用。
它适合「需要 80GB 大显存 + 训练能力」的团队:CUDA 生态完美,从 PyTorch 到 vLLM 全部原生支持,多卡 NVLink 成熟。
短板:带宽与算力已被 Blackwell 超越(绝对性能约为 H100 一半、B200 四分之一);400W 功耗;价格高企。它胜在成熟与可得性。
支持模型
下表为在本设备 / 同级配置上的推荐量化与运行表现:
| 模型 | 量化 | 运行情况 |
|---|---|---|
| Llama 3.1 70B | FP16/Q4 | 优秀 |
| Qwen2.5 72B | FP16/Q4 | 优秀 |
| DeepSeek-R1 671B | 多卡 | 规模部署 |
| FLUX / SDXL | FP16 | 批量高效 |
AI 性能测试
LLM 文本测试
本机实测主流大模型的推理速度(受版本/量化影响,供参考):
- Qwen2.5 72B FP16 (vLLM)≈600+ token/s
- Llama 3.1 70B Q4≈500+ token/s
ComfyUI 出图测试
测试环境:默认采样步数,生成单张耗时:
- FLUX (1024×1024)≈4-5 秒
- SDXL 批量 (1024×1024)≈2-3 秒/张
推荐配置
数据中心训练/推理节点
- GPU 形态SXM 8 卡模组 / PCIe
- CPU双路 Xeon / EPYC
- 互连NVLink + 200G/400G
- 内存可达数 TB 级池
- 电源机柜级供电与散热
- 适合微调 / 推理 / 科研
面向有预算限制但需要大显存的机构,或作为云租用的等价选择。
部署方案
成熟部署:vLLM/TensorRT 直接支持 Ampere,80GB 显存用于 70B 级(FP16/Q4)微调与推理非常从容;PyTorch 生态零额外适配。
适合人群
适合人群
- ✅ 高校与中小企业
- ✅ 云 GPU 租用用户
- ✅ 科研团队
- ✅ 预算型训练/推理需求
不适合人群
- ❌ 大规模前沿训练(建议 B200/H100)
- ❌ 无运维能力的小团队
使用场景
预算型方案的核心:作为大学/研究机构的训练与推理主力,或云端常租实例;结合多卡 PCIe 可实现百亿级模型训练实验。
核心对比
NVIDIA A100 80GB vs H100 SXM
| 项目 | NVIDIA A100 80GB | H100 SXM |
|---|---|---|
| 架构 | Ampere (GA100) | Hopper (GH100) |
| 显存 | 80GB HBM2e | 80GB HBM3 |
| 带宽 | 2 TB/s | 3.35 TB/s |
| FP16 | ≈312 TFLOPS(稀疏) | ≈989 TFLOPS(稀疏) |
| Transformer Engine | 无 | 有 |
| AI 性能 | ★★★★☆ | ★★★★★ |
购买建议
- A100 80GB 现在主要通过二手市场、云租用或整机商渠道获得。
- 选购二手务必验卡(跑显存压力测试),并确认供货合规性与发票。
- 如果只是短周期训练,云租用比自购更省心;若长期运行,二手 A100 是成本敏感方案的优选。
- 获取 A100 优先考虑云租用(成本透明、弹性好),或经合规经销商采购二手整机。
- 二手淘卡务必验机(显存压力测试 + 合规证明),警惕翻新与打磨卡。
- 长期负载再评估自建的经济性。
上手步骤
- 1第一步:在云平台租用 A100 80GB 实例做 PoC
- 2第二步:以 PyTorch + vLLM 跑通 70B 级训练/推理基线
- 3第三步:根据负载决定续租、长期租或采购二手整机
- 4第四步:采购时完成验机与合规确认,纳入正式环境
价格走势
- 1H100/B200 上市后价格明显回落
- 2二手市场存量充足、性价比高
- 3受管制影响,流通渠道需甄别
延伸阅读
A100 80GB 的一切参数——80GB HBM2e、2TB/s 带宽、312 TFLOPS(稀疏)FP16——在今天依然实用:类型全栈兼容、生态无缝。它代表「上一代旗舰的成熟红利」:训练/微调/推理一手抓,对预算有限的机构与科研团队,是最容易上手的 80GB 大显存方案。A100 80GB 代表「被验证的基石」:两代 AI 浪潮用它训练与推理,今天它依然是 80GB 市场最稳的存量选择。
实验结论
A100 80GB 是「上一代数据中心标准件」,却在二手与云计算市场里依旧极具生命力。它的核心优势是 80GB 显存 + 2.0TB/s 带宽的组合,让 40B-70B 级模型的量化推理有足够的驻留空间;社区实测 Llama 3.1 8B Q4 单卡约 125 token/s(r/LocalLLaMA),Qwen 32B 在 vLLM 高并发下也能跑出不错的聚合吞吐。
要认清的两点:一是 A100 是典型的「带宽受限」芯片——解码阶段几乎完全受显存带宽支配,2.0TB/s 相对 H100 的 3.35TB/s 有明显差距,因此在大批量推理和长上下文场景上硬拼 H100 并不划算;二是训练才是 A100 的主场,FP16 624 TFLOPS / TF32 312 TFLOPS 的算力当年支撑了无数大模型的预训练。
对本地 AI 玩家,A100 80GB 的真正价值在于「二手价格 + 大显存」。一块二手 A100 80GB 价格相比 4090 高出不多却多出 56GB 显存,非常适合跑 70B-80B 量化模型、文生图多工作流常驻,以及 vLLM 多租户推理。缺点同样显眼:被动散热/涡轮/服务器形态胶着、送风与供电环境要求高,普通人机箱装不下。
运行建议:A100 请务必用 Linux + 驱动作业,TensorRT-LLM 或 vLLM 均能较好发挥;Windows 下驱动支持弱且显存管理差,强烈不推荐桌面使用。
结论:A100 80GB 是「工作站/机房向」的性价比战士,适合跑大模型量化与多路推理的进阶用户。智算工坊实测:待测试。
A100 80GB 是 80GB 稳定主力:2.0TB/s + 完美 CUDA 生态,训练推理两用。
提示:追求吞吐选 H200/B200;A100 的竞争力在于存量、生态与价格回调。
数据来源与可信度
以下数据来自公开评测与社区实测,均标注来源;无法核实的内容统一标注「智算工坊实测:待测试」。
- r/LocalLLaMA 用户实测:A100 80GB Llama 3.1 8B Q4_K_M(llama.cpp)生成 ≈125 token/s
- DataBaseMart vLLM 实测:DeepSeek-R1-Distill-Qwen-7B(vLLM 50并发)聚合 ≈3,362 token/s,每用户 ≈66.8 token/s
- easecloud vLLM 指南:A100 单卡 Llama 2 7B 批处理 ≈2,500 token/s(聚合)
- A100 80GB 官方规格:HBM2e 80GB、2.0TB/s、FP16 624 TF、TDP 400W
- 智算工坊实测:待测试
常见问题(FAQ)
A100 还主流吗?
存量训练主力,云 GPU 平台上仍常见,性价比适合长期训练。
与 H100 比?
无 Transformer Engine,算力弱于 H100。
A100 80GB 还适合新项目吗?
如果预算有限又需要 80GB 显存训练/推理 70B 级,A100 依然非常合适;追求前沿训练则建议 B200/H100。
它与 L40S 怎么选?
A100:大显存、适合训练与多卡;L40S:新架构、性价比高、适合推理。按业务重心选择。
A100 能跑 405B 模型吗?
400B 级需多卡(建议 6–8× A100 80GB)配合张量并行,基础设施要求高。
A100 80GB 比 40GB 值在哪?
显存直接翻倍,70B 模型的 FP16 微调或大 batch 训练不再受限,性价比对训练场景明显更高。
二手 A100 与云租哪个保险?
二手便宜但有合规与翻新风险,云租省心弹性;长期稳定负载可评估自建,短期/实验用租最合适。
A100 还值得买吗?
团队已有生态或预算受限时值得;全新投资建议直接 H200/B200。
80GB 能跑多大模型?
70B Q4 单卡全驻;180B Q4 需 4 卡 TP;405B 需 8 卡以上。
为什么 A100 仍是标杆?
训练稳定性、多卡互联与生态兼容是它被验证多年的核心优势。
相关推荐
相关文章
结语
一句话:A100 80GB 让「用得起的大显存」变得现实。