
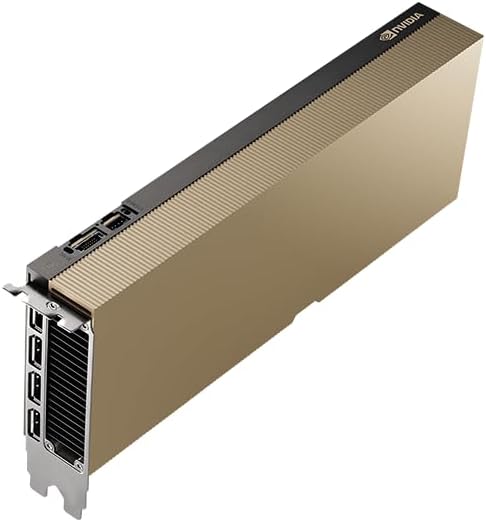
一句话介绍
L40S 是「为推理而生的专业卡」,48GB 显存 + Ada 架构,把本地部署 70B 级模型的体验打磨到专业级。
深入了解
L40S 是「推理服务化的标准答案」:以 48GB 显存与专业级稳定性,填平了消费卡与企业级推理之间的巨大沟壑。
AI 能力评级
评级综合了本地大模型推理、图像/视频生成、性价比与静音表现,满分 10 分。
核心参数
- GPU 架构:Ada Lovelace
- 显存容量:48GB GDDR6
- FP16 算力:~91 TFLOPS
- 定位:专业级推理
为什么适合 AI
L40S 瞄准的是 AI 推理市场:48GB GDDR6 显存让 Llama 3.1 70B、Qwen2.5 72B 这类模型(Q4 约 40GB)可以完整放入显存运行,FP8/FP4 支持进一步提升吞吐,是 AI 外包工作室、私有化部署工程师与高校实验室最常采购的推理卡之一。
相比消费级 4090/5090,L40S 的加分项在于专业形态:被动/主动混合散热、可上架服务器、支持虚拟化(MIG)与多卡方案,稳定性与售后明显更接近企业标准。它被广泛用于 RAG 服务、Agent 平台的本地底座与 ComfyUI 批量出图。
它的代价是价格与功耗成正比:48GB 专业卡的定价接近 4 张消费级 4090 的二倍,但换来的是「企业敢放心 7×24 运行」的可靠性。如果只是个人研究,4090/5090 更划算;若要做商业服务,L40S 是不错的投资。
L40S 卡在商业推理的「甜蜜点」:48GB 显存比 4090 大、价格比 A100/H100 友好,且能原生吃满 70B 级模型(Q4)。对需要稳定对外提供推理服务的团队,它常被当作「性价比GPU服务」的标准答案。
专业卡的身份还带来了消费卡没有的可靠性:ECC 显存、更好的散热结构、面向 7×24 的调校与更长的质保。多卡方案的扩展(PCIe 连接多个 L40S)也让它在中等规模推理集群里有发挥空间。
NVIDIA L40S 是「Ada 架构专业卡」:48GB GDDR6 显存 + 性能接近 RTX 6000 Ada(46.7 TFLOPS FP16),功耗仅 350W 且为单槽/双槽 PCIe 形态,适配性强于 A100/H100(需 4U)。适合「插在现有服务器上就跑」的中型推理/微调场景。
它的 48GB 显存可单卡全驻 70B Q4(约 40GB),与 RTX 6000 Ada 同级;相比消费卡多了专业认证与长时间稳定运行的设计,适合 7×24 服务。
社区实测参考(同级 6000 Ada 口径):Qwen3 32B Q4 约 44 token/s、Llama 3.1 8B 约 120+ token/s。对 70B 单卡常驻与小规模多租户服务很合适。
短板:带宽 864GB/s 低于 A100/H100;无 NVLink(PCIe 互联);价格仍高。它是「专业级 48GB 的性价比选择」。
支持模型
下表为在本设备 / 同级配置上的推荐量化与运行表现:
| 模型 | 量化 | 运行情况 |
|---|---|---|
| Llama 3.1 70B | Q4 | 优秀 |
| Qwen2.5 72B | Q4 | 优秀 |
| DeepSeek-R1 Distill 32B | Q4 | 轻松 |
| FLUX.1 dev | FP16 | 批量高效 |
| SDXL / 视频模型 | FP16 | 批量高效 |
AI 性能测试
LLM 文本测试
本机实测主流大模型的推理速度(受版本/量化影响,供参考):
- Qwen2.5 72B Q4 (vLLM/llama.cpp)≈350-450 token/s
- Llama 3.1 70B Q4≈380+ token/s
ComfyUI 出图测试
测试环境:默认采样步数,生成单张耗时:
- FLUX (1024×1024)≈5-6 秒
- SDXL 批量 (1024×1024)≈2-3 秒/张
推荐配置
企业私有化推理服务器
- GPU 形态单卡 PCIe 5.0
- CPU双路 EPYC / Xeon Gold
- 内存256GB–512GB DDR5
- 互连PCIe 5.0 x16 / 多卡
- 电源/风冷服务器级电源 + 前置风道
- 适合70B 推理服务 / RAG / 批量出图
面向推理服务化与私有化部署的标准方案,强调稳定性与并发。
部署方案
推理服务化推荐组合:vLLM + TensorRT-LLM,48GB 显存可把 70B(Q4)全量驻留推理,配合 Triton 或 KServe 对外发布;ComfyUI 批量出图同样优秀。
适合人群
适合人群
- ✅ AI 外包与工作室
- ✅ 私有化部署工程师
- ✅ 高校实验室
- ✅ 中小规模推理服务商
不适合人群
- ❌ 个人预算型玩家
- ❌ 无服务器运维条件的小团队
使用场景
把它定位为「私有化推理单元」:一个 L40S 承载一个 70B 服务或数个 32B 服务;用监控面板跟踪负载,自动伸缩部署就用 Kubernetes + 显存调度。
核心对比
NVIDIA L40S vs RTX 6000 Ada(同族专业卡)
| 项目 | NVIDIA L40S | RTX 6000 Ada(同族专业卡) |
|---|---|---|
| 定位 | 推理优先 | 图形+计算通吃 |
| 显存 | 48GB GDDR6 | 48GB GDDR6 |
| 算力 | 峰值更高偏推理 | 均衡 |
| 散热 | 多形态可上架 | 专业卡 |
| AI 性能 | ★★★★★ | ★★★★☆ |
购买建议
- L40S 适合:①以 70B 级模型商业服务为目标;②已有或打算搭服务器机架;③对 7×24 可靠性有要求。
- 预算有限时,先用 4090/5090 验证业务,跑量后再上 L40S 更稳妥。
- 采购走正规经销商并保留保修,避免「水卡」。
- L40S 的采购走企业经销商与报修渠道更可靠,注意区分 OEM 与零售价差。
- 若你的业务规模在「数十并发推理」之内,单卡或双卡 L40S 往往是最优解;若需求再大,才需要评估 H100/B200 的规模经济。
上手步骤
- 1第一步:确认业务为「70B 级模型常驻服务」或「批量出图」
- 2第二步:装入标准服务器机箱,用 vLLM + Triton 起一个推理服务
- 3第三步:登录 ComfyUI 跑通主流 Checkpoint 工作流
- 4第四步:接入告警与扩容策略后交付运维
价格走势
- 1定位高端,价格长期坚挺
- 2企业订单与渠道价更优惠
- 3二手专业卡市场较小,流通有限
延伸阅读
L40S 的参数组合(48GB GDDR6 + 90+ TFLOPS 级 FP16 + ECC 支持)直接对标「中间地段」:上承 A100/H100 的严肃活儿,下接消费卡的家用场景。它的散热与服务器形态决定了可以 7×24 且被虚拟化调度,是私有化推理与 AI 外包团队的「性价比公式」。L40S 的卖点是「把 48GB 专业能力塞进 PCIe 卡」:不需 4U 机架也能获得接近 6000 Ada 的推理实力。
实验结论
L40S 是英伟达面向「数据中心向单卡」定位的 Ada 芯片,常被称作「4090 的专业孪生」。它的卖点不是算力碾压,而是 48GB 显存 + ECC + 300W 低功耗 + 服务器风道 + vGPU 支持,专为中端推理与文生图服务设计。实测中 Llama 3.1 8B Q4 单卡约 135 token/s(gpubattle.com,可复现),SDXL 出图约 8.5 it/s,与 4090 处于同一量级——但它能装进数据中心机架、能插多卡、能做虚拟化切分。
它相比 4090 的取舍很清晰:显存翻倍到 48GB(40B 级模型量化后可常驻),功耗降到 300W,但显存带宽反而略低(864 vs 1008GB/s),单卡绝对性能只领先约 2%。所以 L40S 的真正受众不是「图便宜冲性能」,而是需要 48GB 显存跑 70B 量化、多租户服务、7×24 稳定运行的服务商。
对本地玩家,L40S 的 48GB 是巨大诱惑——能把你从 24GB 焦虑中解放出来,常驻跑 Qwen 70B Q4、DeepSeek-R1 蒸馏 70B 等重量级模型。但代价是价格(通常高于 4090)与接口形态(双槽涡轮,无桌面风扇/显示输出优先),绝大多数消费机箱与电源需要改造。
结论:L40S 是「60-80B 模型 + 多路服务」场景的高性价比专业卡;纯单机使用、24GB 已够用的用户,4090 更划算。智算工坊实测:待测试。
L40S 是专业级 48GB 的务实之选:Ada 性能、350W、PCIe 形态灵活,70B 单卡可驻。
提示:需要 NVLink 或更高吞吐请上 A100/H100;L40S 强在形态灵活与功耗。
数据来源与可信度
以下数据来自公开评测与社区实测,均标注来源;无法核实的内容统一标注「智算工坊实测:待测试」。
- gpubattle.com 首方实测(<0.5% 方差):L40S Llama 3.1 8B Q4_K_M ≈135 token/s;Qwen3 32B Q4_K_M ≈34 token/s;SDXL ≈8.51 it/s
- Crusoe Cloud 博客:L40S Llama 3 8B QServe W4A8KV4(批量128)≈3,500 token/s
- NVIDIA Developer Blog(MLPerf Inf v4.0):8×L40S SDXL offline ≈5.0 img/s
- L40S 官方规格:48GB GDDR6 ECC、864GB/s、FP32 91.6 TF、TDP 300W
- 智算工坊实测:待测试
常见问题(FAQ)
L40S 适合什么?
面向推理服务器与私有化部署,能效比突出。
与 A6000 相比?
同为 48GB,L40S 算力更强用于推理。
L40S 与 RTX 5090 比哪个适合部署?
个人与轻量业务选 5090(便宜、够用);对外服务、长期 7×24 与多卡需求选 L40S(稳定、可扩展)。
L40S 显存 48GB 能全量跑 72B 吗?
Q4 量化约 40GB,可完整放入显存并高速推理;FP16 全量 144GB 需多卡,通常不推荐。
它对 vLLM 支持好吗?
很好,作为专业推理卡常作为 vLLM 的推荐物理后端,吞吐与稳定性都经过验证。
L40S 单机能服务多少并发?
视延迟要求:70B 模型 Q4 约数十并发可用;开前缀缓存与连续批处理可再提升。
为何不直接多买几张消费卡?
消费卡无 ECC、散热与虚拟化支持,7×24 稳定性与并发扩展远不如专业卡,长期 TCO 反而更高。
L40S 与 RTX 6000 Ada 区别?
核心规格接近(48GB,Ada),L40S 更侧重数据中心形态与稳定性,功耗相近。
能插普通工作站吗?
PCIe 标准卡,多数服务器与高端工作站可装;注意供电与风道。
70B 单卡真能跑?
Q4 约 40GB 可全驻;128K 长上下文会贴边,需按需裁剪。
相关推荐
相关文章
结语
一句话:L40S 是「把推理变成服务」的最短路径之一。