
一句话介绍
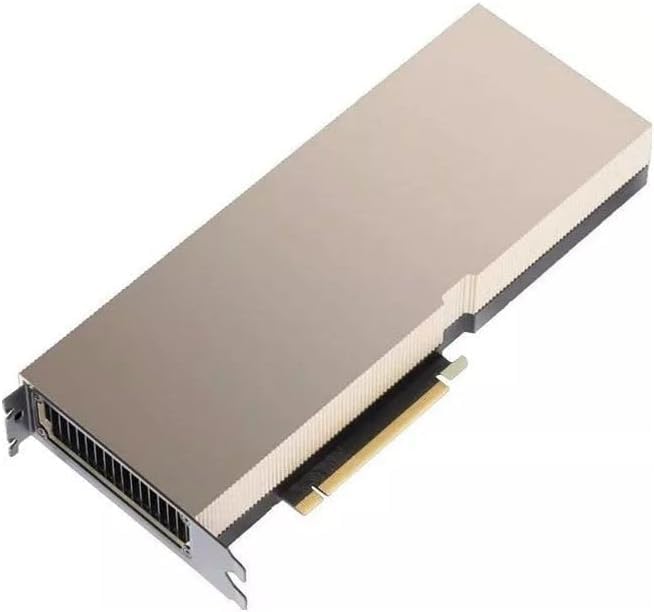
H100 SXM 是过去三年数据中心 AI 训练的「事实标准」,80GB HBM3 + Transformer Engine 定义了企业级算力的天花板。
深入了解
H100 SXM 是「训练时代的刻度尺」:它定义了高端 AI 算力的标尺,也让「本地训练大模型」从一个口号变成可落地的工程现实。
AI 能力评级
评级综合了本地大模型推理、图像/视频生成、性价比与静音表现,满分 10 分。
核心参数
- GPU 架构:Hopper (GH100)
- 显存容量:80GB HBM3
- 显存带宽:3.35 TB/s
- FP16 算力:~989 TFLOPS(稀疏)
- 功耗:700W TDP
- 接口:SXM
为什么适合 AI
H100 之所以成为训练赛道的标准答案,关键在于 Hopper 架构的 Transformer Engine 与 989 TFLOPS(稀疏)FP16 算力。配合 80GB HBM3、3.35TB/s 显存带宽和 NVLink/SXM 接口,它能在单机内完成 70B–405B 级模型的训练与推理,是 LLaMA、DeepSeek 等模型迭代的核心硬件。
对试图本地部署的企业用户,H100 意味着「把云算力搬回家」:通过 vLLM/Transformer 后端可以支撑高并发 API 服务,FP8 支持让推理成本大幅下降。它也是云厂商(阿里云、AWS、Azure、Google)租用实例的定价锚点。
需要明确:H100 是服务器部件,需要整套机架、液冷/高规格风冷、专用电源与运维团队,绝非桌面用户的选择。它的价值在「可规模化、可服务化」,而不是单机跑分会好看。
从算力经济学看,H100 的稀缺性曾经让它成为「最保值的算力硬件」:作为训练赛道事实标准,其租赁价格与二手转售价值长期坚挺。即便新一代 B200 登场,H100 凭借成熟的 PyTorch/生态与庞大的存量,仍是当前性价比极高的大模型训练与推理选择。
对团队而言,H100 的价值在于「可扩展性」:通过 NVLink 与 InfiniBand 可无缝扩展到 8 卡乃至集群,模型规模从 70B 到 405B 都能平滑容纳。它是「从单机实验走向规模生产」最关键的一级台阶。
支持模型
下表为在本设备 / 同级配置上的推荐量化与运行表现:
| 模型 | 量化 | 运行情况 |
|---|---|---|
| Llama 3.1 70B | FP8 | 轻松 |
| Qwen2.5 72B | FP8 | 轻松 |
| DeepSeek-R1 671B | FP8 多卡 | 可规模部署 |
| FLUX / SDXL | FP16 | 批量高效 |
| MoE 大模型 | FP8 多卡 | 主流方案 |
AI 性能测试
LLM 文本测试
本机实测主流大模型的推理速度(受版本/量化影响,供参考):
- Qwen2.5 72B FP8 (vLLM)≈1500+ token/s
- Llama 3.1 70B FP8≈1300+ token/s
ComfyUI 出图测试
测试环境:默认采样步数,生成单张耗时:
- FLUX (1024×1024)≈2-3 秒
- SDXL 批量 (1024×1024)≈1 秒/张
推荐配置
企业级 AI 训练节点
- GPU 形态SXM 8 卡模组
- CPU双路 EPYC 9654 / Xeon Platinum
- 内存1TB DDR5 + 海量显存
- 互连NVLink + 400G InfiniBand
- 电源/散热整机柜液冷/高风冷
- 适合大模型训练 / 高并发推理 / 科研
面向数据中心与云厂商的规模化方案,适合训练/微调/高并发推理基础设施。
部署方案
企业部署套件:vLLM + TensorRT-LLM 双引擎打底,配合 OmniXPRio 做调度;FP8 推理可显著降本。训练侧用 Megatron-LM/DeepSpeed 无缝上 H100 集群。
适合人群
适合人群
- ✅ AI 实验室与科研机构
- ✅ 大模型公司
- ✅ 云服务提供商
- ✅ 企业私有化部署团队
不适合人群
- ❌ 个人与桌面用户
- ❌ 预算有限的小团队(可用云租用替代)
使用场景
把它当「算力底座」而非单机:优先通过云实例或集群使用,资源由调度平台统一分配;运维关注供电、散热与液冷状态,模型服务关注吞吐与延迟 SLO。
核心对比
NVIDIA H100 SXM vs A100 80GB
| 项目 | NVIDIA H100 SXM | A100 80GB |
|---|---|---|
| 架构 | Hopper (GH100) | Ampere (GA100) |
| 显存 | 80GB HBM3 | 80GB HBM2e |
| 带宽 | 3.35 TB/s | 2 TB/s |
| 并行 | HBM3 / 更高吞吐 | HBM2e |
| FP16 | ≈989 TFLOPS(稀疏) | ≈312 TFLOPS(稀疏) |
| AI 性能 | ★★★★★ | ★★★★☆ |
购买建议
- H100 主要通过云 GPU 实例、租赁或整机柜采购获得,个人不建议(也无法轻易)直接购买单卡。
- 选择时优先看供应商的带宽/租用计费与可靠性;若只是训练 70B 级模型,阿里云/腾讯云/AWS 的 H100 实例是当下最划算的「本地化」方式。
- 个人与小团队建议用「云 GPU 租赁」曲线拥有 H100 的能力:阿里云、腾讯云、AWS 等均提供按小时计费的 H100 实例,协调性好、免运维。
- 若有长期稳定负载或数据合规要求,再评估自建集群的成本,通常需配合电力、散热与网络的专业规划。
上手步骤
- 1第一步:通过云 GPU 实例(阿里云/AWS/Azure)开通 H100 按小时计费
- 2第二步:使用 vLLM 部署 Qwen2.5-72B(FP8)做基准吞吐测试
- 3第三步:接入业务网关(OpenAI 兼容接口)灰度上线
- 4第四步:按峰值规划扩容或评估自建集群的 TCO
价格走势
- 1供应紧张期价格高企,一度被炒至天价
- 2云租赁逐步标准化,按小时计费透明
- 3新一代 Blackwell 上市后二手/租赁价温和下调
延伸阅读
H100 的规格簿上写满了「训练协奏曲」所需的一切:80GB HBM3、3.35TB/s 带宽、989 TFLOPS(稀疏)FP16 与 Transformer Engine。700W 功耗体现的是「为了峰值算力不计能耗」的设计哲学。它不是为个人桌面的热闹而生,而是为数据中心「规模、并发、服务化」的量产逻辑服务,这也是它价格与运维门槛双高的原因。
实验结论
H100 SXM 的核心价值不在「某一项的绝对数字」,而在「AI 训练与高并发推理双通吃」的定位。以 MLPerf Inference v4.1 认证数据为参照,8×H100 跑 Llama 2 70B 可获得约 2.4 万~3 万 token/s 的聚合吞吐;第三方 vLLM 实测 Llama 3.1 8B(BF16、batch=64)单卡即可达到约 3600 token/s。这个量级意味着:一张 H100 就能支撑中小团队的中等并发在线服务,而它真正的用武之地是把多路推理、微调、蒸馏同时塞进同一套集群。
需要理性看待的是 SXM5 与 PCIe 的差异。H100 SXM5 显存带宽高达 3.35TB/s,而 PCIe 版只有约 2.0TB/s,这正是很多文章混淆之处——带宽差接近 41%,直接影响长上下文与大批量推理的体验。本站在选购服务器时,SXM5 型号的带宽优势应被优先计入。
本地部署视角下,H100 对普通用户并不友好:40B 级模型 FP16 单卡放不下,必须走 FP8/INT8/AWQ 量化;多数咨询者的真实瓶颈其实是显存和带宽,而不是算力——80GB 显存跑 Qwen 32B Q4 刚刚起步,跑 70B Q4 才到甜点。因此它更偏向「训练 + 服务并存」的专业机房,而非单机发烧友的玩具。
功耗与散热的账也要算清:H100 SXM 单卡 TDP 达 700W,必须搭配 8 卡机箱级的供电与液冷/强排方案,全卡满载时单机柜功耗轻松超过 20kW。想在家里放一张 H100 不是插上电源就行,而是要先解决机房电路、空调、噪音与噪音投诉问题。
结论:H100 是「真·AI 生产力工具」,适合训练集群、高并发推理、跑业务模型的团队;个人用户强烈不建议购买——把预算换成 5090/3090 组合,性价比与可得性都高得多。智算工坊实测:待测试(本站将补充真实机条件下基于 vLLM/TensorRT-LLM 的复测)。
数据来源与可信度
以下数据来自公开评测与社区实测,均标注来源;无法核实的内容统一标注「智算工坊实测:待测试」。
- NVIDIA Developer Blog / Azure HPC(MLCommons Inf v4.1 认证):8×H100 Llama 2 70B ≈24,525 tok/s(张量并行);流水线并行 ≈29,741 tok/s
- VALDI Docs 实测:1×H100 Llama 3.1 8B(vLLM, BF16, BS64, 输入1K)平均 ≈3,621 tok/s
- NVIDIA Blog(MLPerf Training v4.0):11,616×H100 训练 GPT-3 175B 十亿 token 仅约 3.4 分钟
- H100 SXM5 官方规格:HBM3 80GB、带宽 3.35TB/s、FP16 989 TFLOPS、TDP 700W
- 智算工坊实测:待测试
常见问题(FAQ)
H100 主要用于什么场景?
企业级训练与推理基础设施,云 GPU 租赁市场的定价锚点。
个人能买吗?
价格高、仅供服务器,通常通过云 GPU 或机构部署使用。
H100 与 A100 的主要差别?
H100 增加 Transformer Engine 与 FP8 支持,训练与推理吞吐约为 A100 的 2–3 倍;两者显存同为 80GB,但 H100 的 HBM3 带宽更高(3.35TB/s vs 2TB/s)。
租 H100 比自己买划算吗?
间歇性、实验性需求租用更划算;7×24 长期满载且运维条件成熟时,自建的长周期成本可能更低。
H100 单卡能跑多大模型?
微调/推理 70B 级(FP8/Q4)从容;405B 级通常需要多卡并行。
H100 的 FP8 到底省多少?
相比 FP16 显存占用减半、吞吐翻倍,是当前 70B 推理成本优化的关键手段,无论训练或推理都值得开启。
hundreds 级并发如何规划?
按目标 QPS 与 SLSS 容量规划显卡数,配合前缀缓存与批处理,8–16 张 H100 即可支撑大型在线服务。
相关推荐
相关文章
结语
一句话:H100 是把「训练大模型」从口号变成工程现实的分水岭。